SEO-специалист в агентстве упирается в потолок: три-четыре IT-проекта, и он тонет в ручных ТЗ. Каждое техзадание под SaaS или B2B-продукт собирают с нуля — семантика, структура, метатеги, LSI-слова. На один документ уходит по несколько часов, а клиентов хочется брать больше. SEO в айти устроено иначе: продуктовые запросы, длинные сделки, сложные термины. Шаблоны из ecommerce здесь не работают. Разберем, как собрать конвейер: автоматизировать сбор ядра, кластеризацию и черновики ТЗ под типовые IT-страницы, а человеку оставить проверку фактов и докрутку экспертности.
- IT-SEO требует другого подхода: основной трафик идет по информационным и техническим запросам (про интеграции, документацию), а не по коммерческим ключам, как в ecommerce. Контентная воронка должна вести читателя от проблемы через обучение к продукту через перелинковку между стадиями осознания.
- Ручное создание ТЗ — узкое место: один SEO собирает одно ТЗ 3–5 часов, что ограничивает масштабирование до 3–4 проектов. Без автоматизации маржа падает, так как новые сотрудники не добавляют системности, а просто размножают проблему.
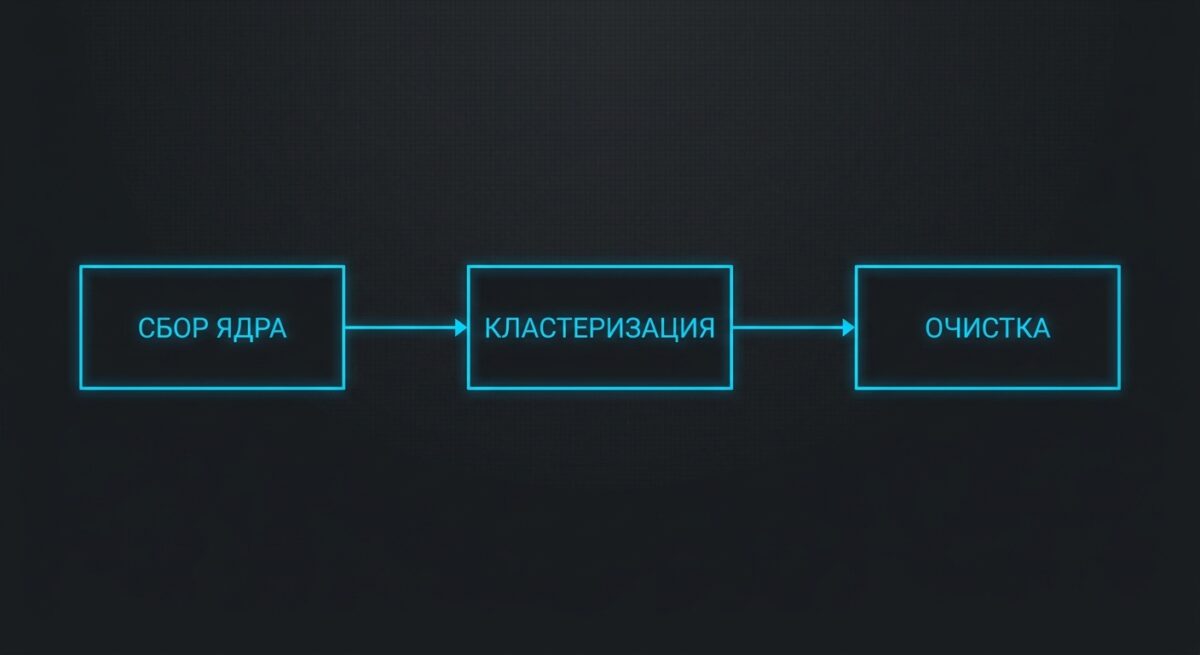
- Конвейер автоматизации включает три звена: сбор ядра через API (вместо ручного парсинга), кластеризацию по выдаче и смыслам через алгоритмы (80% без человека), очистку от мусора через скрипты. На выходе — чистая структура запросов, готовая к нарезке на типы страниц.
- Шаблонизация ТЗ под типы IT-страниц (фичи, интеграции, pricing, docs, кейсы) и LLM-генерация черновиков сокращают время подготовки на 70%, но финальную проверку фактов и экспертность закрывает SEO-редактор. Один специалист с конвейером тянет 8–10 проектов вместо 3–4, стоимость лида падает при росте трафика.
SEO в IT: почему привычные методы не работают в B2B и SaaS
IT-ниша отличается разрывом между тем, что ищут пользователи, и тем, что продает компания. В ecommerce запрос «купить кроссовки» ведет к покупке за один визит. В SaaS человек сначала гуглит «как настроить деплой в CI/CD«, через месяц — «сравнение платформ для оркестрации», и только потом смотрит цены. Между первым касанием и сделкой проходят недели, а решение принимает не один человек, а команда: разработчик, тимлид, финансовый директор. Стандартная схема «собрал коммерческие ключи, написал продающую страницу» здесь не работает. Большая часть трафика приходит по информационным и техническим запросам, которые агентства из товарного SEO привыкли игнорировать.
Инфозапросы против продуктовых: в чем подвох для IT
Продуктовые запросы в IT дают мало прямого трафика и высокую конкуренцию. По фразе «CRM для отдела продаж» борются десятки вендоров с большими бюджетами, а частотность ограничена. Основной объем поиска скрывается в технических и обучающих запросах: «как интегрировать API платежей», «настройка вебхуков», «различия REST и GraphQL«. Эти фразы приводят разработчиков и технических специалистов — людей, которые потом рекомендуют продукт внутри компании.
Информационные запросы в IT-сфере — это не просто трафик для галочки. Это единственный способ привлечь технических специалистов, которые в итоге и становятся главными евангелистами вашего продукта внутри компании.
Подвох в том, что инфозапросы нельзя закрывать поверхностным текстом. Разработчик за пять секунд отличит статью, написанную без опыта, от материала с реальными примерами кода и точными терминами. Поэтому семантику в IT делят на два потока: продуктовые ключи под лендинги и pricing, информационные и технические ключи под блог, docs и интеграционные страницы. Каждый поток требует своего типа ТЗ — это первое, что нужно шаблонизировать.
Почему контентная воронка важнее классического SEO в длинных сделках
Сделка в B2B-софте длится от двух недель до полугода. За это время потенциальный клиент читает статьи, сравнивает интеграции, проверяет документацию и кейсы. Один пост в топе не закроет продажу. Нужна цепочка материалов, которая ведет читателя от проблемы к решению. Контентная воронка в IT строится по стадиям осознания: сначала статьи про боль («почему ломается деплой»), затем про подходы («паттерны CI/CD»), потом про инструменты и только в конце про конкретный продукт.
Классическое SEO измеряет успех позициями и трафиком. В IT этого мало. Важно, доводит ли контент от технического запроса к продуктовой странице. Поэтому в ТЗ закладывают перелинковку между стадиями — из обучающей статьи ссылка ведет на страницу фичи или интеграции. Когда агентство описывает такую структуру для каждой ниши один раз, следующие проекты собираются по готовому каркасу, а не с чистого листа.
Как E-E-A-T спасает сложные технологические бренды
E-E-A-T — это оценка опыта, экспертности, авторитетности и достоверности. Для IT это не абстракция: поисковики и читатели проверяют, писал ли материал человек, который реально работал с технологией. Статью про кибербезопасность без указания автора-эксперта, ссылок на стандарты и точных версий протоколов алгоритмы отодвигают вниз. Технические ошибки в тексте убивают доверие быстрее плохих метатегов.
Отсюда роль SEO-редактора в конвейере. LLM и парсеры соберут семантику и черновик структуры. Но подставить имя автора с релевантным бэкграундом, добавить примеры кода, сослаться на официальную документацию и убрать фактические неточности должен человек. В ТЗ под IT-нишу заранее прописывают требования к экспертным вставкам: кто автор, какие источники обязательны, где нужны схемы и код. Так шаблон задает рамку E-E-A-T, а специалист наполняет ее фактами.
🚀 Тексты, которые нравятся поисковикам
ТЗМонстр — умный нейропомощник для SEO и блогов. Автоматически собирает LSI-фразы, генерирует детальное ТЗ и пишет экспертные статьи лучше обычного ChatGPT. От 15₽ за готовый план работы.
Ловушка контент-продакшена: как ручное создание ТЗ убивает рост
Ручное ТЗ — точка, где ломается вся экономика агентства. SEO-специалист собирает семантику под SaaS-продукт, вручную чистит запросы, группирует их по интентам, прописывает структуру и метатеги. На одно техзадание уходит 3–5 часов. При потоке в 20–30 страниц в месяц на клиента специалист физически ведет не больше трех-четырех проектов. Хотите взять пятого клиента — нанимаете второго SEO, платите оклад, тратите время на обучение и контроль. Выручка растет линейно, расходы — вместе с ней. Маржа стоит на месте или падает. Пока производство ТЗ привязано к рукам конкретного человека, агентство не масштабируется, а просто раздувает штат.
Почему масштабирование на коленке съедает вашу маржу
Модель «больше клиентов — больше людей» работает против вас. Оклад мидл-SEO в IT-нише — от 120 тысяч рублей. Один специалист закрывает 3–4 проекта. Чтобы взять восемь клиентов, нужны двое, чтобы шестнадцать — четверо. Прибавьте руководителя группы, который координирует их работу. Каждый новый сотрудник добавляет фонд оплаты труда, но не добавляет системности: ТЗ у всех разные по формату, качество плавает от человека к человеку.
В итоге вы продаете не продукт, а часы конкретных исполнителей. Уходит сильный SEO — вместе с ним уходит понимание, как он делал ТЗ под интеграции или pricing-страницы. Новый сотрудник переизобретает процесс заново. Пока знания и шаблоны живут в головах, а не в системе, каждый новый клиент стоит вам почти столько же, сколько первый. Именно тут маржа и утекает.
Масштабирование за счет найма новых сотрудников без изменения процессов лишь раздувает фонд оплаты труда. Специалисты TzMonster отмечают, что пока экспертиза не превращена в стандартизированные шаблоны, каждый новый клиент обходится агентству по себестоимости первого, безжалостно сжигая маржу.
Главные ошибки при расширении команды без автоматизации
Первая ошибка — нанимать раньше, чем описаны процессы. Владелец агентства чувствует перегруз и берет джуниора, но передать ему нечего, кроме устных объяснений. Джуниор делает ТЗ по-своему, редактор переделывает, и вместо разгрузки появляется вторая точка контроля. Вторая ошибка — отсутствие единого шаблона под типы IT-страниц. Техзадание на страницу фичи, на docs и на сравнение с конкурентом требуют разной структуры, но в агентстве их лепят по одному лекалу.
Третья ошибка — держать всю экспертизу по нишам на одном человеке. Один разбирается в кибербезопасности, другой в облачных сервисах, и проекты нельзя переключить между ними без потери качества. Когда специалист уходит в отпуск или увольняется, проект встает. Расширение команды без стандартов и автоматизации не убирает узкое место, а просто размножает его на несколько человек сразу.
Как производственные «бутылочные горлышки» тормозят ваш выход в топ
Между сбором семантики и публикацией контента стоит очередь. SEO собрал ядро, но ТЗ пишет неделю, потому что параллельно ведет еще три проекта. Копирайтер ждет ТЗ и простаивает. Готовый текст возвращается на проверку, а редактор занят другим клиентом. Одна страница проходит путь от запроса до публикации не за два дня, а за две-три недели. При этом конкуренты в нише SaaS выкатывают по 40–50 материалов в месяц.
В IT-тематике скорость решает: индексация новых фич, обновление документации, свежие сравнения продуктов дают трафик здесь и сейчас. Пока ТЗ — ручной этап-затор, вы физически не успеваете закрывать кластеры запросов быстрее конкурентов. Топ занимают те, кто наращивает объем качественного контента, а вы отдаете позиции не из-за слабого SEO, а из-за медленного производственного конвейера.
| Этап производства контента | Ручной подход | Автоматизированный конвейер |
|---|---|---|
| Сбор семантики | Дни ручного парсинга конкурентов | Минуты (выгрузка через API) |
| Кластеризация | Ручная сортировка тысяч строк | ML-алгоритмы и эмбеддинги |
| Создание черновика ТЗ | 3-5 часов на один документ | Генерация за 2-3 минуты |
| Роль специалиста | Сборщик данных и копирайтер | Редактор, эксперт и фактчекер |
Строим конвейер: автоматизируем семантику для IT-проектов
Конвейер начинается со сбора ядра, а не с написания ТЗ. Пока SEO вбивает запросы в сервис вручную и выгружает по одному кластеру, он тратит день там, где хватило бы часа. Автоматизация делится на три звена: сбор запросов через API, кластеризация через алгоритмы и очистка через скрипты. Каждое звено убирает ручной труд на 60–80% и стандартизирует результат под IT-ниши — SaaS, облачные сервисы, инструменты для разработчиков. На выходе получается чистая структура запросов, готовая к нарезке на страницы фич, интеграций и документации. Разберем каждое звено.
Использование API поисковиков для сбора ядра
Ручной парсинг подсказок из строки поиска не масштабируется. Вместо этого агентства подключают API: Яндекс.Wordstat отдает частотности пакетами, а сервисы вроде Keys.so, Serpstat или Ahrefs выгружают запросы конкурентов сразу в таблицу. Для IT это критично: часть терминов существует только на английском, часть — калькой (деплой, пайплайн, вебхук), и собрать их вручную легко пропустить.
Настраивают сбор так: скрипт берет 5–10 сайтов-конкурентов в нише SaaS или DevOps, тянет их видимые запросы через API и складывает в единый файл. Параллельно догружает подсказки по маркерным словам продукта. За один прогон собирается ядро на 3–5 тысяч фраз — объем, который SEO собирал бы неделю. Дальше это ядро уходит на кластеризацию.
Машинное обучение на страже автоматической кластеризации
Кластеризация по общности выдачи группирует запросы по тому, какие URL Google и Яндекс показывают в топе. Если по двум фразам совпадает 3–4 сайта из топ-10, их сажают на одну страницу. Сервисы Just-Magic, KeyCollector или Topvisor делают это автоматически, без ручной сортировки тысяч строк.
Для IT добавляют смысловую кластеризацию через LLM или эмбеддинги. Алгоритм понимает, что «интеграция с Slack» и «подключить Slack» — одна страница, а «API документация» — отдельная. Это разводит запросы по типам IT-страниц: фичи, интеграции, pricing, docs. Человек проверяет спорные кластеры, где машина сомневается, но 80% групп формируются без него.
Чистим семантику от мусора с помощью скриптов
После сбора в ядре остаются нецелевые фразы: запросы про конкурентов, вакансии, пиратские версии, регионы вне гео клиента. В IT-семантике мусора особенно много — «скачать бесплатно», «crack», «для студентов» тянут нерелевантный трафик. Скрипт на Python со списком стоп-слов вычищает это за секунды по всему файлу.
Минус-слова собирают один раз под нишу и переиспользуют: для SaaS — «взлом», «торрент», для DevOps — названия несовместимых стеков. Скрипт также режет дубли и фразы с нулевой частотностью. На выходе — очищенное ядро, разбитое по кластерам, где каждая группа готова стать основой для черновика ТЗ. К этому этапу и переходит следующая часть конвейера.
Шаблонизация ТЗ: превращаем опыт экспертов в точные инструкции
IT-страницы делятся на типы: фичи, интеграции, pricing, документация, кейсы. У каждого типа своя логика: страница фичи отвечает на вопрос «что это решает», страница интеграции — «как это соединяется с моим стеком», pricing — «сколько и за что». Раз структура повторяется, ТЗ под нее можно описать один раз и переиспользовать. Задача SEO-редактора смещается: вместо написания каждого документа с нуля он один раз фиксирует требования к типу страницы, а дальше подставляет семантику и правит детали. Так знания сильного специалиста превращаются в инструкцию, по которой работает даже джун.
Создаем библиотеку шаблонов: от фич до клиентских кейсов
Разложите проекты на повторяющиеся типы страниц и заведите под каждый отдельный шаблон. Для страницы фичи пропишите блоки: проблема пользователя, как функция ее закрывает, скриншот интерфейса, сравнение с ручным способом. Для интеграции — список поддерживаемых сервисов, шаги подключения, требования к тарифу. Шаблон pricing фиксирует таблицу планов, FAQ по оплате и блок сравнения. Каждый шаблон — это не текст, а каркас с обязательными смысловыми блоками.
📌 Чек-лист: Базовые шаблоны для IT-сайта
- Страницы фич (Features): Описание проблемы, механика решения, скриншоты интерфейса.
- Интеграции (Integrations): Сценарии подключения, требования к API, лимиты обмена данными.
- Ценообразование (Pricing): Сравнительная таблица тарифов, скрытые квоты, FAQ по биллингу.
- Документация (Docs): Примеры кода, архитектура решения, частые ошибки (troubleshooting).
- Кейсы (Cases): Исходная задача клиента, процесс внедрения, измеримый результат в цифрах.
Кейсы вынесите в отдельный шаблон со своей рамкой: клиент и его ниша, задача, внедренное решение, цифры до и после. Такой блок закрывает коммерческий интент и подтверждает экспертность. Когда библиотека собрана, новый проект стартует не с чистого листа, а со сборки из готовых элементов. SEO подбирает нужные шаблоны под карту сайта клиента и передает их дальше на наполнение семантикой — к этому переходим ниже.
Интеграция SEO-требований в структуру документа: от метатегов до заголовков
В каждый шаблон заранее вшейте SEO-каркас, чтобы автор не собирал его вручную. Для Title задайте формулу под тип страницы: «[Название фичи] — [что решает] | [Бренд]» для фич, «Интеграция [Продукт] с [Сервис]» для страниц интеграций. Description опишите как правило: до 160 символов, главный запрос в первых словах, призыв к действию в конце. H1 привяжите к основному кластеру, а не к точному вхождению — в IT-нишах переспам ключей режет читаемость сложного текста.
Заголовки H2–H3 в шаблоне заранее покрывают подтемы кластера: у страницы интеграции это «как настроить», «требования», «частые ошибки». Так структура документа отражает намерения пользователя еще до написания текста. Автору остается подставить конкретный продукт и данные, а не выдумывать логику разделов. Метатеги и заголовки перестают быть отдельной задачей — они рождаются вместе с ТЗ. Следующий шаг — наполнить этот каркас связями и терминологией.
Автоматическая простановка линков и LSI-слов в ТЗ
Перелинковку в IT-проектах опишите правилами внутри шаблона, а не вручную для каждой страницы. Страница фичи ссылается на связанные фичи, релевантную интеграцию и pricing. Страница интеграции ведет на документацию и кейс из той же ниши. Задайте эти связи как логику типов страниц — тогда при генерации ТЗ инструмент подставит ссылки автоматически по карте сайта, а SEO-редактор только проверит, что якоря ведут на актуальные URL и не создают циклов.
Перелинковка в сложных нишах не должна делаться вслепую. Заложив строгую логику связей прямо в шаблон техзадания, вы автоматически выстраиваете бесшовный путь пользователя от первого знакомства с функцией до изучения тарифов.
LSI-слова соберите из кластера запросов на этапе семантики и подтяните в ТЗ списком обязательных и желательных терминов. Для SaaS это профессиональная лексика: «API», «вебхук», «SLA», «онбординг», названия конкурентов и стеков. LLM генерирует черновой перечень из ядра, человек чистит нерелевантное и добавляет отраслевой контекст, который модель не знает. В итоге автор получает ТЗ, где линки и терминология уже размечены, — остается написать экспертный текст поверх готовой разметки.
LLM как двигатель генерации IT-контента
LLM берет на себя рутину: превращает кластер запросов в черновик ТЗ и текста за минуты. Для IT это работает, если модель понимает контекст продукта. Запрос «интеграция с API» в SaaS — это описание сценария подключения, а не обзорная статья. Модель нужно кормить фактурой: документацией, описанием фич, тарифами, кейсами. Тогда она собирает черновик страницы фичи, интеграции или сравнения с конкурентом. Но LLM выдумывает несуществующие функции и цифры, поэтому итог всегда проверяет SEO-редактор. Ниже — три узла конвейера: тон, структура, поток черновиков через API.
Промт-инжиниринг: учим нейросеть говорить в Tone of Voice вашего бренда
Дефолтный текст LLM легко узнать: обтекаемые фразы, канцелярит, обещания без конкретики. Для IT-клиента это провал — разработчик или CTO закроет вкладку на первой водной фразе. В системный промт закладывают правила бренда: короткие предложения, запрет на оценочные штампы, обращение на «вы» или на «ты», уровень технической глубины. Отдельно прописывают глоссарий: как называть продукт, какие термины использовать, что переводить, а что оставлять на английском.
Промт усиливают примерами. Дают модели два-три эталонных абзаца из уже одобренных текстов клиента — она подхватывает ритм и лексику. Добавляют антипримеры: «так писать нельзя» с пояснением почему. Один такой шаблон промта фиксируют под каждого IT-клиента и переиспользуют на всех страницах. Смена клиента — меняется только блок с ToV и глоссарием, каркас конвейера остается прежним.
Как создавать структуру статей на основе анализа топ-10
Структуру не берут из головы — ее собирают из выдачи. Парсер выгружает топ-10 по целевому запросу, из каждой страницы вытягивает заголовки H2–H3, объем, наличие таблиц и блоков FAQ. LLM группирует эти заголовки и показывает, какие подтемы встречаются у всех конкурентов, а какие — только у одного. Так видно обязательный минимум структуры и зоны, где можно обойти топ за счет недостающего блока.
Для IT-ниш анализ уточняют по типу страницы. Для страницы фичи в топе обычно идут блоки «как работает», «сценарии применения», «настройка», «ограничения». Для сравнения — таблица с конкурентом и разбор по параметрам. Модель формирует скелет с этими секциями и указывает, какие вопросы закрыть в каждой. Редактор смотрит на результат, убирает лишние подтемы конкурентов и добавляет то, чего в выдаче нет, но что важно для продукта клиента.
Автоматизируем создание черновиков для блога через API
Ручной прогон через веб-интерфейс не масштабируется. Связку строят через API: таблица с кластерами и метаданными по каждой странице подается на вход, скрипт по очереди отправляет промты в модель и складывает черновики обратно в таблицу или CMS. За ночь один процесс генерирует десятки заготовок под блог и продуктовые страницы сразу для нескольких клиентов.
Каждый запрос к API собирают из трех частей: блок ToV клиента, структура из анализа топа, фактура по конкретной теме. На выходе — черновик с заголовками, метатегами и размеченными местами под цифры и кейсы. Черновик не публикуют напрямую: он попадает к SEO-редактору на проверку фактов, вычитку терминов и добавление экспертных деталей. Автоматизация закрывает 70% рутины, а качество держит человек на финальном этапе.
Автоматизация через API позволяет за одну ночь сгенерировать десятки структурированных черновиков. Нейросеть берет на себя всю рутину по парсингу выдачи, оставляя человеку самую ценную работу — фактчекинг и добавление живого опыта.
Роль SEO-редактора в эпоху автоматизации: от контроля фактов до экспертизы
Конвейер собирает семантику и генерирует черновик ТЗ, но подписывает работу редактор. LLM не знает, что интеграция вашего клиента с Kubernetes вышла из беты только вчера, и легко напишет про несуществующий тариф или устаревший API. В IT-нишах цена такой ошибки выше, чем в обычном SEO: аудитория читает документацию и ловит фактические ляпы за секунды. Задача редактора смещается со сборки текста на три вещи: проверить техническую точность, добавить фактуру, которую машина не найдет, и прогнать материал по чек-листу. Ниже разберем каждый блок.
Почему автоматизация не заменит человека: проверка технической точности
Модель генерирует текст по паттернам, а не по актуальной документации клиента. Она уверенно напишет, что SaaS поддерживает SSO через SAML, хотя в продукте только OAuth. Для страниц фич, интеграций и pricing такие расхождения читатель замечает сразу и уходит. Редактор сверяет каждое утверждение с реальным продуктом: список интеграций, лимиты тарифов, названия методов API.
Проверка идет по источникам клиента, а не по выдаче. Откройте changelog, техдокументацию, актуальный прайс — и правьте черновик под факты. Особенно это касается версий, дат релизов и цифр. Автогенерация экономит время на структуре и первичном тексте, но техническую достоверность закрывает только человек, который держит в голове контекст конкретного продукта.
Фактура и докрутка экспертности: где нужен взгляд редактора
Черновик от LLM описывает продукт общими словами: «удобный интерфейс», «гибкая настройка». В B2B и SaaS это не продает и не ранжируется. Нужна фактура: конкретный сценарий использования, цифры по производительности, сравнение с конкретным конкурентом, скриншот настройки. Такие детали редактор берет из брифа клиента, интервью с продактом или тикетов поддержки — машина к этим данным доступа не имеет.
Экспертность докручивается ответами на реальные вопросы аудитории. Для страницы интеграции это «как настроить вебхук», «что делать при ошибке аутентификации». Редактор добавляет эти блоки, потому что видит, какие запросы задают в сообществах и саппорте. Так шаблонный черновик превращается в материал, который решает задачу разработчика или технического закупщика, а не пересказывает лендинг конкурента.
Финальный контроль качества: настраиваем чек-листы для редакторов
Чтобы один редактор вел больше проектов, проверка стандартизируется в чек-лист под каждый тип IT-страницы. Для фичи: соответствие названия функции продукту, наличие сценария применения, метатеги с целевым кластером. Для pricing: актуальность цен, полнота тарифов, ответы на частые вопросы по биллингу. Для docs: точность команд и параметров. Чек-лист привязан к типу страницы, а не к клиенту — это и дает масштабирование.
Каждый пункт формулируется как проверяемое условие: «все цены сверены с прайсом от DD.MM», «нет упоминаний несуществующих интеграций», «вхождение ключа в H1 и Title». Редактор проходит список за 15–20 минут вместо часа ручной вычитки. Ошибки, которые повторяются, добавляются в чек-лист новыми пунктами — так документ дорабатывается на каждом проекте и снижает нагрузку на следующих задачах.
Метрики успеха: как измерить профит от автоматизации в IT
Автоматизацию оценивают по четырем цифрам: время на выпуск одного ТЗ, стоимость лида, качество трафика и число проектов на одного специалиста. Без этих метрик внедрение инструментов становится тратой денег на подписки. Владелец агентства должен видеть, что конвейер сбора семантики и генерации черновиков ТЗ сокращает часы работы редактора и не роняет позиции в выдаче. В IT-нишах это особенно заметно: страницы фич, интеграций и pricing требуют точной терминологии, поэтому важно измерять не только скорость, но и долю ТЗ, прошедших проверку без переделок. Разберем каждую метрику отдельно.
Скорость выпуска контента: как меняется время на производство ТЗ и статей
Ручное ТЗ под SaaS-страницу собирают 3–4 часа: парсинг конкурентов, кластеризация запросов, подбор LSI-слов, структура заголовков. Конвейер сокращает этот этап до 30–40 минут. Инструмент выгружает ядро, группирует запросы по типам страниц, а LLM генерирует черновую структуру и метатеги. Редактор проверяет термины и добавляет продуктовые смыслы, которых нет у алгоритма.
Искусственный интеллект мастерски имитирует экспертную уверенность, но совершенно не разбирается в реальных характеристиках вашего продукта. Без строгой редакторской вычитки по документации сгенерированный текст лишь отпугнет профессиональную аудиторию.
Замеряйте время по этапам, а не общее. Сбор семантики автоматизируется почти полностью, кластеризация — на 80%, а финальная докрутка ТЗ остается ручной. Так вы увидите, где конвейер реально экономит часы, а где человек все еще незаменим. Для типовых IT-страниц — docs, фичи, сравнения — экономия достигает 70% времени на подготовку документа.
Снижаем стоимость лида при масштабировании трафика
Стоимость лида падает, когда трафик растет быстрее расходов на его производство. Если один редактор выпускает вдвое больше страниц за те же деньги, цена привлечения по каждой снижается. В IT-нишах трафик дороже из-за конкуренции по коммерческим запросам вроде «CRM для B2B» или «облачное хранилище API», поэтому экономия на производстве контента напрямую влияет на юнит-экономику проекта.
Считайте стоимость лида по каждому кластеру страниц отдельно. Информационные статьи под запросы про интеграции приводят дешевых лидов, но с длинным циклом. Страницы pricing и сравнений дают дорогих, но горячих. Автоматизация позволяет закрыть оба типа: конвейер быстро выпускает массу информационных ТЗ, а редактор точечно докручивает коммерческие страницы, где цена ошибки выше.
Оценка качества: от поведенческих факторов до конверсий в MQL
Скорость без качества обваливает позиции. Отслеживайте глубину просмотра, время на странице и отказы: если автогенерированные тексты дают высокий процент отказов, LLM выдал воду вместо продуктовых смыслов. Для IT-контента важен показатель дочитываний технических блоков — документации, схем интеграций, описаний API. Низкое время на таких страницах сигнализирует, что термины поданы неточно.
Качество IT-контента измеряется не позициями в выдаче, а тем, насколько глубоко читатель погружается в технические блоки. Если метрика времени на страницах документации падает, значит, алгоритм выдал водянистый текст вместо сухих фактов.
Финальная метрика — конверсия в MQL, квалифицированный лид. Трафик по продуктовым запросам должен приводить не любопытных, а тех, кто оставляет заявку на демо или регистрируется в триале. Свяжите кластеры страниц с воронкой: страницы фич и сравнений обычно дают больше MQL, чем общие статьи. Так вы поймете, какие типы ТЗ стоит масштабировать через конвейер, а какие писать только вручную.
Масштабируемость процессов: сколько проектов потянет один SEO-специалист
Без автоматизации один SEO ведет 3–4 IT-проекта: больше не позволяет ручная сборка ТЗ и контроль терминологии. С конвейером тот же специалист тянет 8–10 проектов, потому что рутина сбора семантики и черновиков уходит инструментам. Человек переключается с производителя на редактора-контролера: проверяет факты, докручивает продуктовые смыслы, следит за качеством выдачи.
Потолок задает не количество страниц, а сложность ниш. Кибербезопасность и Dev/Cloud требуют глубокой экспертизы, поэтому на такой проект уходит больше ручной проверки, чем на типовой SaaS. Стандартизируйте шаблоны ТЗ под каждый тип IT-страницы — фичи, интеграции, pricing, docs. Чем больше шаблонов готово, тем меньше времени на проект и тем выше число клиентов на одного специалиста.