Ни один детектор не определит со 100% точностью, писал текст человек или ChatGPT. Все они работают на вероятностях: ошибаются на живых авторах и пропускают ИИ после простого перефразирования. Если вы проверяете каждый текст через сервис, считающий «процент AI», и переписываете статьи ради красивой цифры — вы тратите время впустую и рискуете позициями в поисковой выдаче. Google оценивает пользу материала, а не способ его создания. В этой статье разберем, почему детекция ломается на русском и английском языках, и покажем рабочий процесс: как довести ИИ-черновик до качественной статьи через SEO-структуру, фактчекинг, редактуру и экспертизу.
- AI-детекторы работают на вероятностях и часто ошибаются: дают ложные срабатывания на структурные человеческие тексты и пропускают отредактированный AI-контент после простого перефразирования
- На русском языке точность детекции значительно ниже, чем на английском, из-за свободного порядка слов и падежных конструкций — переписывать статьи ради «красивой цифры» бессмысленно
- Google оценивает пользу контента (E-E-A-T: опыт, экспертность, авторитетность, достоверность), а не способ создания — качественный AI-черновик, доведенный через SEO-структуру, фактчекинг и экспертизу, превосходит в выдаче «человеческие» пустые статьи
- Вместо проверки на AI внедрите чек-лист экспертности: наличие компетентного автора, источники данных, практические примеры и факты — это надежнее детекторов и напрямую влияет на ранжирование
Почему ИИ-детекторы бессильны перед качественным контентом
Детектор анализирует не смысл, а статистику: предсказуемость слов, ритм предложений, равномерность конструкций. Тексты нейросетей часто ровные и «средние» по этим параметрам, поэтому алгоритм ставит высокий процент AI. Но стоит автору добавить живые примеры, разбить шаблонные фразы, вставить цифры и личный опыт — текст перестает попадать в статистический профиль модели. Одновременно живой автор, пишущий сухо и по структуре, легко получает ярлык «сгенерировано ИИ». Детектор видит только форму, не замечая пользу, экспертизу и факты. Поэтому качественный материал, доведенный человеком, обходит фильтры не хитростью, а естественностью.
Вероятностная ловушка: почему алгоритмы часто ошибаются
Детектор не выдает вердикт «да» или «нет» — он считает вероятность. Формулировка «85% AI» означает лишь то, что текст статистически похож на выборку, на которой обучали модель детекции. Реальный автор, пишущий чисто и структурно, попадает в тот же профиль и получает ложное срабатывание. Особенно страдают инструкции, юридические и технические тексты: там короткие однотипные фразы, и алгоритм принимает их за машинную генерацию.
Алгоритмы детекции не ищут смысл — они ищут математические паттерны. По опыту компании TzMonster, слепая погоня за ‘нулевым процентом ИИ’ часто приводит к ухудшению читабельности и потере позиций, так как авторы начинают ломать естественную структуру предложений ради обхода фильтров.
Обратная ошибка не менее частая: детектор пропускает ИИ-текст, если тот отредактирован или написан свежей моделью, которой не было в обучающей выборке. Генеративные системы развиваются быстрее детекторов, поэтому разрыв только растет. Опираться на один процент при оценке статьи — значит наказывать хороших авторов и пропускать слабый контент. Цифра детектора — это сигнал перепроверить, а не приговор.
Языковой барьер: как точность детекции зависит от языка
Большинство детекторов обучали на англоязычных данных, поэтому на английском они работают точнее, чем на русском. Русский текст с его свободным порядком слов, падежами и длинными конструкциями сбивает статистические модели: живой автор получает завышенный процент AI, а сгенерированный — заниженный. Для русскоязычного SEO это прямой риск — переписывать нормальный материал ради цифры, которая изначально неточна.
Разница в языках означает одно: универсального детектора нет. Сервис, показавший 90% точности на английских статьях, на русских может ошибаться в разы чаще, и производитель об этом обычно не упоминает. Поэтому переносить выводы англоязычных тестов на русский контент нельзя. Проверяйте на языке публикации и всегда с поправкой на то, что результат приблизительный.
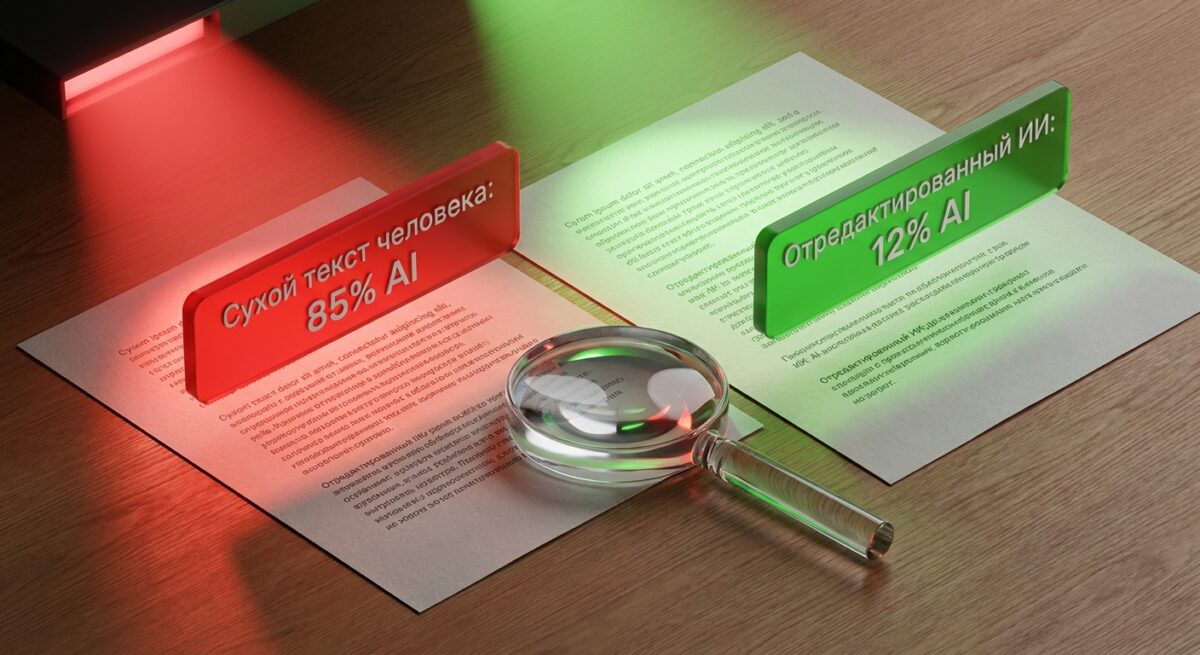
Игра в прятки: как перефразирование обходит фильтры
Процент AI резко падает после простой обработки: замены синонимов, перестановки предложений, разбивки длинных фраз на короткие. Есть отдельные сервисы-«гуманизаторы», которые делают это автоматически и сбивают детектор до «человеческих» значений за один прогон. Смысл текста при этом не меняется — меняется только статистический рисунок, на который смотрит алгоритм.
Отсюда вывод: детектор ловит форму, а не факт использования ИИ. Любой, кому нужно «пройти проверку», обходит ее за минуты, а честный автор без перефразирования может провалить тест. Поэтому строить контроль качества только на детекции бессмысленно — она отсеивает не то. Полезнее оценивать саму статью: факты, структуру, экспертизу и пользу для читателя.
🚀 Тексты, которые нравятся поисковикам
ТЗМонстр — умный нейропомощник для SEO и блогов. Автоматически собирает LSI-фразы, генерирует детальное ТЗ и пишет экспертные статьи лучше обычного ChatGPT. От 15₽ за готовый план работы.
От черновика до топа: как превратить ИИ-текст в качественную статью
ИИ пишет черновик за минуту, но черновик и готовая статья — разные вещи. Модель складывает слова по статистике: она не знает вашей ниши, не проверяет факты и повторяет общие фразы из обучающей выборки. Чтобы такой текст вышел в топ, нужно четыре шага: спроектировать структуру под реальные запросы, выверить факты, вычистить язык и добавить экспертизу, которой у модели нет. Дальше разберем каждый этап отдельно. Именно эта доработка отличает материал, который читатель дочитывает и который Google держит в выдаче, от сгенерированной пустышки.
Чек-лист: 4 шага от ИИ-черновика до топа
- Сбор семантики: кластеризация запросов и формирование структуры заголовков H2-H3.
- Фактчекинг: сверка всех цифр, дат и неочевидных утверждений с официальными источниками.
- Очистка от «воды»: удаление шаблонных вводных конструкций, штампов и канцелярита.
- Внедрение опыта: добавление реальных кейсов, скриншотов из практики и мнений профильных специалистов.
Проектирование структуры под SEO и запросы пользователей
Структуру задают не фантазии автора, а запросы людей. Соберите семантику через Wordstat, Keys.so или подсказки поисковика, сгруппируйте фразы по смыслу и превратите группы в заголовки H2–H3. Так вы закрываете не одну формулировку темы, а десятки связанных вопросов. ИИ на этом этапе полезен: он быстро предложит скелет статьи и варианты подзаголовков, которые вы отберете вручную под собранные ключи.
Проверяйте, отвечает ли каждый блок на конкретный интент. Пользователь ищет «как проверить текст на ИИ» — дайте инструкцию, а не рассуждение о нейросетях. Разбейте длинные разделы на абзацы по 3–4 строки, добавьте списки и таблицы для сравнений. Логичная структура удерживает читателя дольше, а поведенческие факторы влияют на позиции в Google и Яндексе.
Магия редактуры: зачем нужны фактчекинг и экспертный взгляд
ИИ уверенно выдает несуществующие законы, выдуманные цифры и ссылки на исследования, которых нет. Это называют галлюцинациями. Каждый факт из черновика проверяйте по первоисточнику: официальный сайт, документация сервиса, публикация с датой. Утверждение «детектор ловит ChatGPT с точностью 99%» без ссылки на замер — красный флаг, а не аргумент для читателя.
Доверие к сгенерированным фактам — главная ошибка неопытных авторов. Нейросеть не обладает знаниями в классическом понимании, она лишь предсказывает следующее слово. Без жесткого ручного фактчекинга по первоисточникам любой ИИ-черновик остается бомбой замедленного действия для вашей репутации.
После фактчекинга идет языковая редактура по инфостилю: убираете штампы вроде «в современном мире», режете вводные конструкции, заменяете оценки «уникальный» и «потрясающий» на цифры и примеры. Экспертный взгляд ловит то, что модель не видит: устаревшие данные, спорные выводы, подмену причин. Так текст становится плотным и достоверным — именно за это поисковики поднимают его в E-E-A-T.
Добавляем жизнь: как вплести уникальный опыт и экспертизу бренда
Модель обучена на чужих текстах и не расскажет, что случилось на вашем проекте. Именно личный опыт отличает статью от тысячи одинаковых пересказов. Добавьте кейс: «прогнали 20 статей через три детектора — две человеческие пометило как ИИ на 80%». Такой пример нельзя сгенерировать, его дает только практика, и он повышает доверие читателя сильнее любого общего вывода.
Вплетайте цифры из своей аналитики, скриншоты интерфейсов, мнение штатного специалиста, реальные ошибки и то, как вы их исправили. Это компонент Experience в E-E-A-T — Google ценит контент от тех, кто делал руками. Бренд-тон и авторская подача завершают работу: текст перестает быть безликим черновиком и начинает работать на репутацию, а не только на ключевые слова.
| Критерий оценки | Сырой ИИ-черновик | Статья после доработки (E-E-A-T) |
|---|---|---|
| Факты и данные | Галлюцинации, выдуманные цифры | Проверены по авторитетным первоисточникам |
| Стиль и подача | Шаблонные обобщения, «вода» | Инфостиль, плотный и конкретный текст |
| Уникальный опыт | Отсутствует (пересказ чужого) | Кейсы, скриншоты, личная практика автора |
Ставка на пользу, а не на детекцию: стратегия E-E-A-T
E-E-A-T расшифровывается как опыт, экспертность, авторитетность и достоверность. Это критерии, по которым асессоры Google оценивают качество страниц. Ни один из них не проверяет, писал текст человек или нейросеть. Поисковик анализирует, решает ли материал задачу пользователя: есть ли конкретика, примеры из практики, точные данные, автор с подтвержденной компетенцией. Статья, собранная через ИИ и доведенная экспертом, обходит в выдаче «человеческий» текст-пустышку. Поэтому усилия стоит вкладывать не в обход детекторов, а в реальную ценность: факты, структуру и опыт, который виден читателю с первого экрана.
Техническая чистота и грамотность: фундамент доверия поисковиков
Орфографические ошибки, битые ссылки, дубли и обрывающиеся предложения снижают доверие к странице. ИИ-черновик часто содержит скрытые дефекты: повтор одной мысли в разных абзацах, выдуманные цифры, кривые падежные окончания после автозамены. Прогоните текст через проверку орфографии и пунктуации, сверьте все числа с источниками, уберите смысловые повторы. Это база, без которой остальные усилия по E-E-A-T не работают.
Проверка уникальности решает отдельную задачу — она не про ИИ, а про заимствования. Нейросеть может выдать фрагмент, близкий к тексту из обучающей выборки, и такой кусок стоит переписать. Свяжите три инструмента в цепочку: антиплагиат, орфография, фактчекинг. Каждый закрывает свою зону, а вместе они дают технически чистый материал, к которому у поисковика нет формальных претензий.
Почему для Google важна суть, а не способ написания
В официальном руководстве Google по качеству контента прямо сказано: способ создания материала не имеет значения, если контент полезен людям. Автоматически сгенерированный текст ради манипуляции выдачей нарушает правила — но не потому, что его писал ИИ, а потому, что он бесполезен. Статья с реальными ответами на запрос ранжируется независимо от того, набирал ее человек или дорабатывал после нейросети.
Это снимает главный страх редактора: не нужно прятать факт использования ИИ. Нужно снять с черновика типичные признаки бесполезности — обобщения без данных, воду, отсутствие конкретики. Добавьте то, что модель дать не может: свежий кейс, результат замера, цитату специалиста. Именно эти элементы поисковик считывает как сигнал экспертности, и они же отличают материал от сотен похожих в выдаче.
Внутренний контроль: как настроить проверку материалов на экспертность
Вместо охоты за «процентом ИИ» внедрите чек-лист экспертности. Проверяйте каждую статью по пунктам: есть ли автор с указанной компетенцией, приведены ли источники данных, добавлен ли практический опыт, отвечает ли текст на запрос без воды. Такой список работает надежнее любого детектора, потому что оценивает то, что реально влияет на ранжирование, а не гадает о происхождении текста.
Для критичных материалов ведите учет происхождения: фиксируйте, кто писал черновик, кто редактировал, откуда взяты цифры. Это внутренняя политика, а не отчет для поисковика — она защищает от ошибок и упрощает обновление статей. Детекторы ИИ в этой схеме остаются вспомогательным сигналом: если сервис подсветил фрагмент, это повод перечитать абзац на предмет пустоты, но не приговор всему тексту.