Точного числа трафика по ключевым словам не существует. Любой сервис показывает прогноз с погрешностью, Google не отдает реальные данные по каждому запросу. Если ждете волшебный список ключей, который принесет тысячи посетителей, вас ждет разочарование. Трафик по ключевым словам — это модель. Ее собирают из статистики кликов в Search Console, частотности запросов, анализа конкурентов и чтения выдачи. В статье разберемся, почему высокий рейтинг запроса не дает клики, какими сервисами собирать данные, как строить семантику от сырых масок до кластеров по интенту и как проверять гипотезы контентом, а потом править ядро по живой статистике.
- Точного трафика по ключевым словам не существует — все сервисы показывают прогнозы с погрешностью, так как Google не раскрывает реальные данные по каждому запросу; единственный источник фактических цифр — Google Search Console с реальными показами и кликами.
- Высокая частотность запроса не гарантирует трафик — между запросом и переходом стоят позиция в выдаче, оформление сниппета, блоки с ответами и реклама; нужно оценивать связку из конкуренции, типа выдачи и реального потенциала клика.
- Семантическое ядро — это гипотеза, которую проверяют через 4–8 недель после публикации; работа идет циклом: написали контент → замерили результаты → сравнили с прогнозом → исправили по живым данным из Search Console.
- Кластеризацию по интенту нужно группировать по намерению пользователя (коммерческий vs информационный), проверять вручную через реальную SERP и править семантику раз в квартал, добавляя неожиданные запросы с кликами и удаляя фразы со показами без результата.
Анатомия поиска: почему точные цифры трафика по ключевым словам — это миф
Ни один сервис не покажет, сколько человек придет на страницу по конкретному запросу. Причина в устройстве поиска: Google прячет часть данных под пометкой «not provided«, выдача меняется у каждого пользователя, а инструменты вроде Ahrefs или Serpstat работают на выборках и собственных моделях. Цифра частотности в Wordstat или планировщике — это оценка спроса, а не прогноз кликов на ваш сайт. Между запросом и переходом стоят позиция в выдаче, оформление сниппета, блоки с ответами и реклама. Поэтому трафик по ключам считают как диапазон вероятностей, который уточняют живой статистикой.
Ограничения поисковых систем и погрешность сервисов аналитики
Google Search Console отдает реальные показы и клики, но с двумя оговорками: данные усекаются по редким запросам и агрегируются по приватности. Часть ключей вы просто не увидите. Google Analytics после перехода на GA4 почти не раскрывает поисковые фразы — органику приходится сверять с Search Console.
Частотность в планировщиках спроса отражает исключительно теоретический объем поискового интереса, но сама по себе не гарантирует сайту даже единичного перехода из выдачи.
Сторонние сервисы работают иначе. Ahrefs, Serpstat, SimilarWeb строят оценки на базе кликстрима, парсинга выдачи и своих формул CTR. Их цифры по трафику конкурента отличаются в разы между собой. Это не ошибка сервиса, а разная методика. Поэтому одну цифру не берут за истину — сравнивают несколько источников и ищут порядок величин, а не точное значение.
Статистика запросов и реальное поведение пользователей
Частотность запроса в Wordstat или планировщике показывает, сколько раз фразу вводили за месяц по региону. Но это сумма всех интентов: под запросом «купить телефон» скрываются и готовые к покупке, и те, кто просто смотрит цены. Общая частота ничего не говорит о том, кто кликнет именно на ваш материал.
Реальное поведение видно только в Search Console: там связаны запрос, позиция, показы и клики. Эта связка раскрывает, по каким фразам вас уже находят и где CTR проседает. Прогноз по частотности и живая статистика кликов — два разных слоя данных. Первый оценивает спрос заранее, второй показывает факт. Решения принимают, накладывая один слой на другой.
Почему высокий рейтинг запросов не гарантирует клики
Запрос с частотностью 50 000 может приводить меньше трафика, чем фраза на 2 000. Если по высокочастотнику выдачу занимают рекламные блоки, карусель товаров и быстрый ответ прямо в SERP, пользователь получает информацию без перехода на сайт. Доля таких «нулевых» поисков по информационным запросам стабильно растет.
Еще один фактор — позиция и сниппет. Первое место собирает в несколько раз больше кликов, чем пятое, а привлекательный заголовок и описание поднимают CTR даже на средних позициях. Поэтому ключ оценивают не по одной частоте, а по связке: конкуренция, тип выдачи, реальный потенциал клика. Высокий спрос без свободного места в SERP дает мало переходов.
🚀 Тексты, которые нравятся поисковикам
ТЗМонстр — умный нейропомощник для SEO и блогов. Автоматически собирает LSI-фразы, генерирует детальное ТЗ и пишет экспертные статьи лучше обычного ChatGPT. От 15₽ за готовый план работы.
Арсенал специалиста: чем собирать и оценивать данные
Ни один сервис не закрывает задачу полностью. Google Search Console показывает реальные клики и показы, но не видит запросы, по которым страница еще не ранжируется. Ahrefs, Serpstat и SimilarWeb считают частотность и сложность, но их цифры — прогноз, а не факт. Поэтому данные совмещают: реальную статистику берут из Search Console и Analytics, потенциал оценивают по частотности в сторонних базах, конкурентов разбирают отдельно. Дальше разберем каждый инструмент: что он показывает честно, где ошибается и как читать его цифры, чтобы не принять прогноз за гарантию.
Google Search Console как главный источник реальных кликов
Search Console показывает, по каким запросам люди уже видят ваш сайт в выдаче и сколько раз кликают. В отчете «Эффективность» доступны четыре метрики: показы, клики, CTR и средняя позиция. Это единственный источник, где цифры не прогноз, а факт от самого Google. По ним видно, какая страница собирает показы, но теряет клики из-за слабого заголовка или низкой позиции.
| Инструмент | Источник информации | Точность кликов | Основная задача |
|---|---|---|---|
| Google Search Console | Фактическая статистика поисковой системы | Абсолютная (факт) | Анализ реальных кликов, показов и аудит CTR сниппетов |
| Сторонние сервисы (Ahrefs, Serpstat) | Кликстрим, парсинг выдачи и матмодели | Оценочная (погрешность до 50%+) | Разбор видимости конкурентов и поиск упущенной семантики |
| Веб-аналитика (GA4) | Счетчики на целевом сайте | Высокая (сессии) | Оценка поведения пользователя после завершения перехода |
Ограничение одно: GSC видит только то, по чему вы уже ранжируетесь. Запросы с нулевыми показами сервис не покажет — для новых тем нужны сторонние базы. Поэтому GSC используют как точку правды: сверяют с ней прогнозы других сервисов и правят семантическое ядро. Если запрос дает показы без кликов — работают над сниппетом; если кликов нет совсем — проверяют позицию и интент страницы.
Анализ конкурентов и оценка потенциала ниши
Конкуренты показывают, какой трафик реально доступен в нише. Через Ahrefs или Serpstat открывают домен конкурента и смотрят отчет по органическим ключам: какие запросы приводят ему посетителей, на каких позициях стоят страницы и сколько трафика собирает каждая. Так видно потолок ниши и упущенные запросы — их добавляют в свое ядро.
Оценка потенциала строится на разнице между вашими позициями и позициями конкурентов. Если по ключу конкурент стоит в топ-3, а вы на второй странице, запрос реалистичен — контент можно догнать. Сложность запроса (KD) в сервисах подсказывает, сколько ссылок и качества нужно для топа. Высокий KD не значит «не брать»: значит дольше и дороже. Эти цифры тоже прогноз, поэтому их проверяют практикой, а не принимают вслепую.
Сторонние SEO-платформы для мониторинга позиций
Search Console дает усредненную позицию за период, но не отслеживает колебания по конкретным запросам во времени. Для этого ставят трекинг позиций в Serpstat, Ahrefs или Topvisor: сервис ежедневно снимает выдачу по заданному списку ключей и строит график. Так видно, растет страница или падает после обновления алгоритма, и когда гипотеза с контентом сработала.
По опыту компании TzMonster, непрерывный мониторинг средней позиции целого тематического кластера дает бизнесу в разы больше достоверной информации о динамике проекта, чем отслеживание единичных фраз-масок.
Трекеры полезны для контроля кластеров целиком. Вы добавляете группу запросов под одну страницу и следите за средней позицией по кластеру, а не по отдельному ключу. Если кластер стабильно в топ-10 — переходят к следующему. Если позиции скачут — анализируют SERP: сменился ли интент, появились ли новые блоки выдачи. Данные трекера и реальные клики из GSC сводят вместе и на их основе пересматривают приоритеты ядра.
Как работать с семантикой: от сырых запросов до целевых кластеров
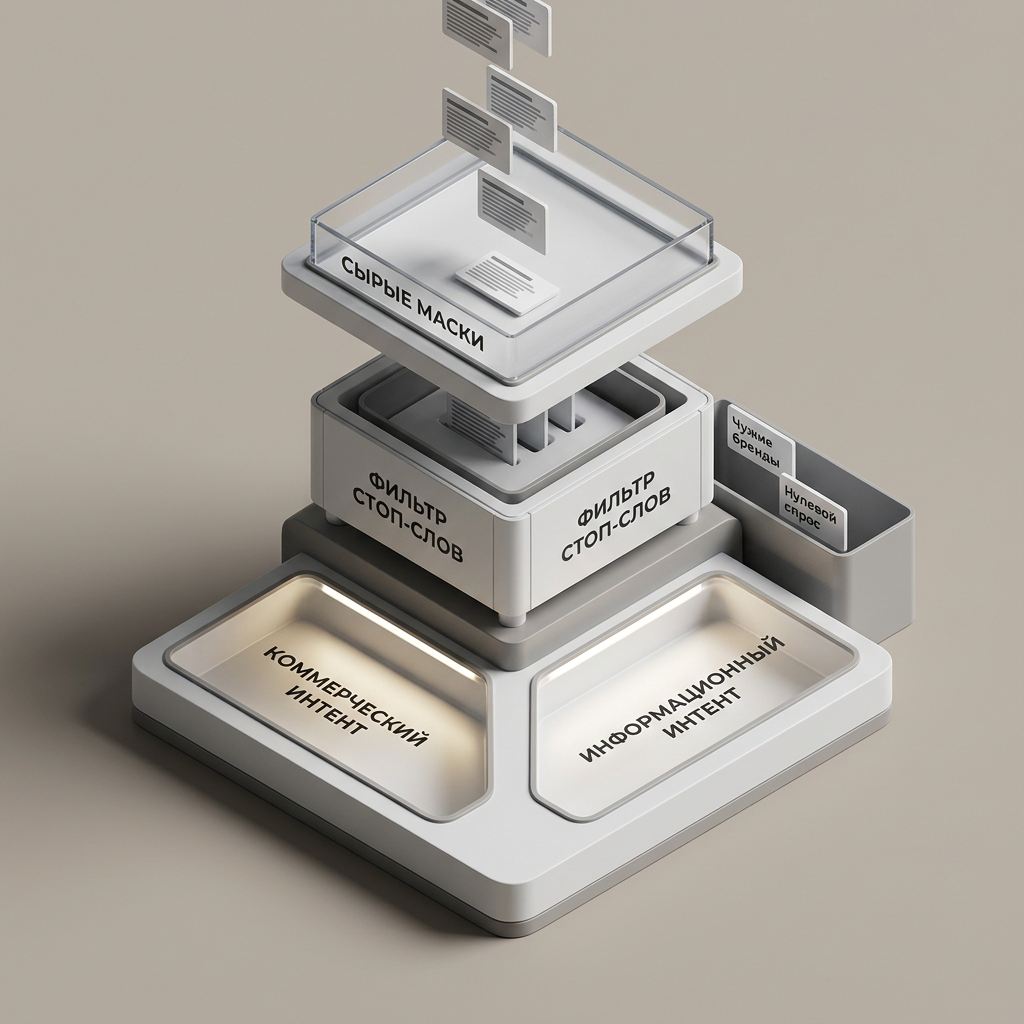
Семантика начинается с масок — коротких базовых фраз вроде «купить кроссовки» или «настроить роутер». На их основе парсеры вытягивают сотни и тысячи расширений. Этот сырой список бесполезен, пока его не почистить и не разбить по смыслу. Рабочая цепочка выглядит так: собрать маски, расширить их через Wordstat, Key Collector, Ahrefs или Serpstat, отсечь мусор и нецелевые фразы, сгруппировать запросы по намерению пользователя и только потом распределить кластеры по страницам. Пропустите этап чистки — получите ядро, где перемешаны коммерческие и информационные запросы, а страницы будут конкурировать сами с собой.
Сбор масок, фильтрация мусора и отсечение лишнего трафика
Маски берут из названий товаров, услуг, проблем клиента и подсказок поиска. Каждую прогоняют через сервис частотности: Wordstat для Яндекса, Keyword Planner и Search Console для Google, Ahrefs или Serpstat для оценки сложности. На выходе — таблица с фразами, частотностью и конкурентами. Здесь важно смотреть не на общую частоту, а на точную в кавычках: она отсекает «пустышки«, где показы есть, а реальных кликов не будет.
Чистку делают по стоп-словам: удаляют упоминания чужих брендов, городов, которые вы не обслуживаете, бесплатные и пиратские запросы, если они не ведут к цели. Отсекают и мусорный трафик — фразы с нулевой частотностью или те, что приводят людей не за вашим продуктом. Пример: интернет-магазин убирает «кроссовки своими руками», потому что эти посетители не купят. После фильтра остается список, с которым уже можно строить структуру, а не гадать.
Кластеризация по интенту для точного попадания в потребности
Кластеризация группирует запросы по намерению: что человек хочет сделать. «Купить», «цена», «заказать» — коммерческий интент. «Как выбрать», «что такое», «отзывы» — информационный. Смешивать их на одной странице нельзя: поисковик не поймет, под какой запрос ранжировать документ. Автоматическую кластеризацию делают по совпадению выдачи — если по двум фразам в топе одни и те же URL, значит, Google считает их одним интентом и их можно вести на одну страницу.
После машинной группировки список проверяют вручную. Алгоритм ошибается на омонимах и редких фразах, поэтому редактор дочищает кластеры и сверяет их с реальной выдачей. Откройте SERP по ключу и посмотрите, что показывает поиск: карточки товаров, статьи, подборки или видео. Этот тип страниц и нужно делать. Так вы попадаете в ожидание пользователя, а не навязываете ему формат, который поисковик уже отбраковал.
Распределение приоритетов и создание структуры страниц
Готовые кластеры ранжируют по приоритету. В расчет берут частотность, коммерческую ценность и сложность продвижения. Высокочастотный запрос с сильными конкурентами может годами не выходить в топ, а среднечастотный кластер с низкой конкуренцией даст трафик за пару месяцев. На старте берут кластеры с хорошим соотношением спроса и сложности — так результат появляется быстрее, а бюджет не сгорает на заведомо проигрышных фразах.
Каждый приоритетный кластер превращается в страницу: одна страница — один интент. Из структуры кластеров собирают карту сайта: разделы под крупные темы, подстраницы под уточнения. Коммерческие кластеры ведут на карточки и категории, информационные — в блог с перелинковкой на продающие страницы. Эту структуру не фиксируют навсегда: после запуска смотрят на Search Console, видят, какие страницы реально приносят клики, и пересобирают ядро под живые данные.
- Анализ типа документов в SERP: проверяйте, совпадает ли формат запланированной страницы (статья, категория, карточка товара) с тем, что Google уже держит в топ-10.
- Оценка перекрытия экрана блоками ответов: фиксируйте наличие колдунщиков, прямых ответов и товарных каруселей, которые забирают клики без перехода на сайты.
- Сопоставление ссылочной сложности: оценивайте параметр сложности фразы до старта подготовки контента, чтобы избежать конкуренции с недосягаемыми трастовыми доменами.
- Закрепление целевого действия: четко определяйте путь посетителя на странице до написания текста, разделяя прямую продажу и первичное ознакомление.
Практика: как проверять гипотезы контентом и корректировать ядро
Семантическое ядро — это гипотеза, пока страница не собрала клики. Вы предполагаете, что кластер из 15 запросов принесет 300 визитов в месяц, но реальная цифра появится только после индексации и 2–3 месяцев накопления данных в Search Console. Поэтому работа с трафиком идет циклом: написали страницу под кластер, дождались индексации, замерили позиции и клики, сравнили с прогнозом, нашли разрыв и исправили. Прогноз Ahrefs или Serpstat задает ориентир, но решения принимают по фактическим показам и CTR. Дальше разберем три шага цикла: как зафиксировать первый результат, как поднять кликабельность и как пересобирать ядро по живым данным.
Индексация страниц и первый замер результатов
Пока страница не в индексе, трафика по ее ключам нет. Отправьте URL на проверку через инструмент «Проверка URL» в Search Console, убедитесь, что страница отдает код 200 и не закрыта в robots.txt. Индексация занимает от нескольких часов до пары недель. Ускорить ее помогает перелинковка с уже ранжирующихся страниц и свежая карта сайта.
Первый осмысленный замер делают через 4–8 недель. Откройте отчет «Эффективность» в Search Console, отфильтруйте по URL и выгрузите запросы, по которым идут показы. Сравните этот список с вашим кластером: часть ключей совпадет с прогнозом, часть окажется неожиданной. По неожиданным запросам смотрите среднюю позицию — именно они подскажут, куда двигать контент дальше.
Главная ценность первых двух месяцев после запуска контента заключается в поиске незапланированных запросов в панели вебмастера, которые вообще не фигурировали в прогнозах сторонних сервисов.
Тестирование для улучшения кликабельности
Страница в топ-5, а кликов мало — значит, сниппет проигрывает конкурентам. Проверьте CTR по запросу в Search Console и сравните с типичным для этой позиции: на первом месте он держится в районе 20–30%, на пятом — около 5–7%. Если ваш показатель ниже, проблема в заголовке и описании, а не в позиции.
Меняйте по одному элементу за раз: сначала title, через 2–3 недели — description, затем структуру сниппета через микроразметку и FAQ-блок. После каждой правки фиксируйте дату и следите за CTR по тому же запросу. Так вы отделяете эффект изменения от колебаний выдачи и понимаете, что именно подняло кликабельность.
Регулярный пересмотр семантики по живой статистике
Выдача меняется, конкуренты публикуют новые материалы, у пользователей появляются свежие формулировки запросов. Раз в квартал выгружайте из Search Console запросы с показами, но без кликов — по ним страница видна, но не отвечает интенту. Если таких запросов много и они об одном, это сигнал вынести их в отдельный кластер и создать новую страницу.
Обратная ситуация: запрос приводит клики, которого не было в исходном ядре. Добавьте его в семантику и усильте соответствующий раздел текста. Так ядро превращается из разового файла в живой документ, который вы правите по фактическому трафику, а не по разовому прогнозу частотности на старте проекта.