Вставили текст из ChatGPT в статью, а она не растет в выдаче. Дело не в самой модели, а в том, как с ней работают. Сырой генеративный контент проседает по трем фронтам: нет собранной семантики, обрывается контекст в длинных диалогах и размывается экспертность. Плюс есть слой, который вы не почините: серверные сбои OpenAI и политика хранения данных вы не контролируете. Зато вы контролируете процесс. Разберем, где ломается этот контент, как ChatGPT может нарушать конфиденциальность и коммерческую тайну, и как выстроить работу с моделью, чтобы тексты ранжировались. Без магии, на уровне процессов.
- Сырой контент из ChatGPT не ранжируется из-за потери контекста в длинных диалогах, отсутствия собранной семантики и размытой экспертности — решение: короткие блоки с внешним хранилищем данных и готовыми кластерами ключевых слов
- Данные, отправленные в ChatGPT, могут использоваться OpenAI для обучения моделей — риск утечки коммерческой тайны решается лимитированием чувствительных данных и обезличиванием информации в промптах
- Модель пишет уверенно с правдоподобными ошибками: подставляет вымышленные цифры и исследования — требуется обязательная проверка фактов и редакторская доработка человеком перед публикацией
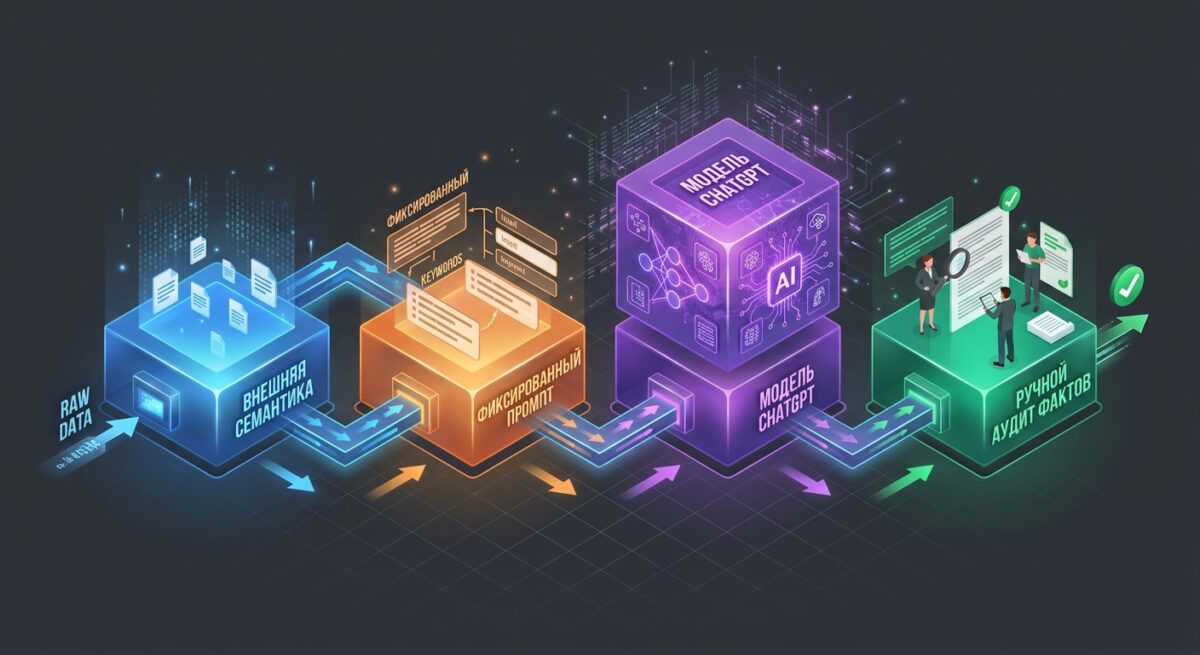
- Эффективный конвейер: семантическое ядро из сервисов → жесткие шаблоны промптов → генерация → ручной редакторский аудит с проверкой источников и добавлением уникальных данных для экспертности
Почему сырые тексты из нейросети не ранжируются: главные архитектурные ошибки
Сырой текст из ChatGPT не попадает в топ по четырем причинам: модель теряет контекст в длинных диалогах, не учитывает семантическое ядро, генерирует правдоподобную воду вместо фактов и дублирует структуру под сотни конкурентов. Поисковик видит статью без смысловой глубины, с размытой интентом и слабыми поведенческими сигналами. ChatGPT пишет грамматически гладко, но не знает вашу семантику, редполитику и задачи пользователя. Пока эти пробелы закрывает человек на этапе подготовки и доработки, текст остается полуфабрикатом. Разберем каждую ошибку отдельно.
Иллюзия компетентности нейросети опаснее явной ошибки: искусственный интеллект формулирует вымышленные факты с непоколебимой уверенностью, превращая красивый черновик в мину замедленного действия для ранжирования.
Потеря смыслового объема: как обрывается контекст при длинных диалогах с ChatGPT
У модели ограниченное окно контекста. В длинном диалоге ранние вводные вытесняются, и к середине статьи ChatGPT забывает структуру ТЗ, список ключей и тональность. Абзацы начинают противоречить друг другу: термин определяется дважды, тезис из первого раздела исчезает к четвертому. Чем больше объем, тем сильнее расплывается логика.
Решение — не держать весь проект в одном чате. Контекст выносят во внешнее хранилище: отдельный файл с каркасом статьи, базой фактов и регламентом. В ChatGPT передают короткие блоки с нужными данными под каждый раздел. Так модель работает с актуальной вводной, а не с обрывками переписки, и смысловой объем не рассыпается.
Опасность утечек: конфиденциальность и коммерческая тайна в эпоху ИИ
Данные, отправленные в ChatGPT, уходят на серверы OpenAI и могут использоваться для обучения, если это не отключено в настройках. Внутреннюю политику хранения вы не контролируете. Поэтому клиентские базы, незапущенные продукты, внутренняя аналитика и персональные данные в промптах — прямой риск утечки коммерческой тайны.
| Категория риска | Опасность сырого промпта | Регламент защиты |
|---|---|---|
| Коммерческая тайна | Попадание финансовых метрик в обучающую выборку OpenAI | Передача данных в обезличенном виде (индексы вместо выручки) |
| Потеря контекста | Искажение ТЗ и забывание ключевых слов после 3-4 итераций | Дробление статьи на изолированные блоки с внешним хранением каркаса |
| Галлюцинации фактуры | Генерация вымышленных законов, цифр и ложных кейсов | Обязательный фактчекинг редактором перед отправкой в CMS |
Рабочий подход — лимитировать чувствительные данные на входе. В промпт передают обезличенные вводные: вместо реальных цифр выручки — условные, вместо имен клиентов — роли. Чувствительные расчеты оставляют вне модели. Регламент по тому, что можно и нельзя отправлять в ИИ, закрывает большую часть рисков без отказа от инструмента.
Иллюзия качества: как бесконтрольный генеративный контент ломает редполитику
ChatGPT пишет уверенно даже там, где ошибается. Модель подставляет правдоподобные цифры, несуществующие исследования и общие формулировки, которые читаются гладко, но не несут пользы. Без проверки такой текст нарушает редполитику: появляются штампы, пустые оценки и никем не проверенные факты.
Чтобы иллюзия качества не прошла в публикацию, генеративный текст проходит обязательную человеческую доработку. Редактор сверяет факты с источниками, вычищает воду по инфостилю, проверяет соответствие интенту и тональности. Модель дает черновик, а соответствие стандартам обеспечивает человек по регламенту — иначе статья выглядит экспертной, но таковой не является.
Мнимая семантика: чем опасна замена кластеризации ключей поверхностным рерайтом
ChatGPT не знает частотность запросов и не строит кластеры. Если попросить его написать статью по теме, он выдаст текст с очевидными синонимами, но без низкочастотных ключей, LSI-фраз и структуры под реальную выдачу. Это мнимая семантика: слова на тему есть, а охвата поисковых интентов нет.
Семантику собирают до обращения к модели. Ключи выгружают из сервисов, кластеризуют по интентам и группируют в разделы будущей статьи. ChatGPT получает готовый список фраз под конкретный блок и раскрывает их в тексте. Так модель работает по вашей семантике, а не по своей догадке, и статья покрывает запросы, а не имитирует тему поверхностным рерайтом.
🚀 Тексты, которые нравятся поисковикам
ТЗМонстр — умный нейропомощник для SEO и блогов. Автоматически собирает LSI-фразы, генерирует детальное ТЗ и пишет экспертные статьи лучше обычного ChatGPT. От 15₽ за готовый план работы.
Инженерный подход к контенту: как превратить нейросеть в мощный инструмент роста трафика
Нейросеть не заменяет SEO-специалиста — она автоматизирует отдельные операции. Рост трафика дает не генерация как таковая, а конвейер: семантика, структура, промпты, редактура. Когда каждый шаг описан и повторяем, модель выдает предсказуемый результат, а тексты закрывают конкретные запросы из кластера. Такой подход снимает главную претензию к ИИ-контенту — хаотичность: вместо запроса «напиши статью про X» вы управляете каждым элементом страницы. Отсюда рабочее правило: сначала проект, потом чат. Дальше разберем три звена конвейера, где качество закладывается или теряется: подготовка ядра, проектирование промптов и редакторский аудит.
По опыту компании TzMonster, попытка генерировать статьи целиком через одиночные запросы снижает конверсию на 40%: реальный рост трафика обеспечивает только расщепление ТЗ на микрозадачи с предварительной ручной кластеризацией.
Подготовка семантического ядра: собираем структуру до того, как открывать чат с моделью
Семантическое ядро собирают вне ChatGPT: в Key Collector, Топвизоре или выгрузках из Вордстата. Модель не видит реальную частотность и конкурентность запросов, поэтому ее представления о нише — фантазия без цифр. На выходе должен быть очищенный список запросов, разбитый на кластеры по интенту: коммерческие, информационные, навигационные. Каждый кластер — отдельная страница со своим заголовком и перечнем подтем.
Готовые кластеры загружают в чат списком и просят разложить их по разделам будущей статьи. Модель работает не из головы, а по вашей структуре — текст изначально попадает в запросы, по которым есть спрос. Промежуточные таблицы храните в отдельном документе: при обрыве контекста восстановите бриф за минуту.
Каркасное проектирование: создаем жесткие шаблоны промптов для полного контроля выдачи
Шаблон промпта — инструкция с фиксированной структурой: роль, задача, объем, список разделов, LSI-слова, запреты. Создайте библиотеку таких шаблонов под типовые задачи: статья-каркас, переработка абзаца, генерация мета-тегов, ответы на вопросы из блока «Похожие запросы». Переменные меняете под кластер, остальное держите неизменным — качество перестает зависеть от формулировки, придуманной на ходу.
Жесткие рамки решают и проблему обрыва контекста: каждый новый чат получает полный бриф из шаблона, а не пересказ предыдущей переписки. Результат сравнивают с эталоном и отклоняют, если модель ушла от структуры. Один шаблон — один тип задачи, без смешения инструкций в одном диалоге.
Ручной редакторский аудит: финальная доработка фактуры и экспертности живым человеком
Сгенерированный текст проходит вычитку человеком до публикации. Редактор проверяет факты: цифры, даты, названия законов и сервисов — модель уверенно искажает их и выдумывает несуществующие источники. Затем снимает повторы, канцеляризмы и обтекаемые формулировки, добавляет примеры из практики и данные, которых нет у конкурентов из топа.
Последний фильтр — экспертность: подпись автора с регалиями, ссылки на первоисточники, уникальные скриншоты и расчеты. По критериям качества Google и Яндекса именно такие признаки отличают полезный материал от массы шаблонных ответов нейросети. Без этого слоя текст ранжируется слабо, каким бы гладким он ни был.
- Верификация числовых данных: сверка каждой цифры, статистики и упомянутого исследования с первоисточником.
- Удаление смыслового балласта: зачистка абстрактных вводных оборотов, канцеляризмов и шаблонных выводов.
- Атрибуция экспертизы: внедрение цитат профильных специалистов, реальных скриншотов рабочих кабинетов и авторских расчетов.
- Семантический аудит: контроль вхождения заданных LSI-терминов без переспама и потери естественности слога.