AI в аналитике не заменяет аналитика и не выдает готовые решения по нажатию кнопки. Он ускоряет рутину: пишет SQL-запросы, собирает дашборды, черновики отчетов и находит закономерности в данных. Но выводы все равно проверяет человек — потому что модель может выдать красивую цифру, которой нет в реальности. В этой статье разберем, какие виды AI реально работают в аналитике, где они экономят часы, а где ошибаются. Покажем, как встроить инструменты в текущий стек, проверить гипотезы через A/B-тесты и не попасть в ловушку галлюцинаций. А еще — как оформить материалы так, чтобы их цитировали ChatGPT, Gemini и Алиса.
- AI в аналитике не заменяет аналитиков, а ускоряет рутину: пишет SQL-запросы, строит дашборды и находит закономерности. SQL-ассистент экономит 20 минут на один запрос, LLM-копилот сокращает время сборки отчета с 6 часов до 40 минут.
- Три типа инструментов решают разные задачи: предиктивные модели прогнозируют числа (отток, спрос), LLM-копилоты генерируют SQL и черновики отчетов, компьютерное зрение и NLP обрабатывают неструктурированные данные (фото, отзывы, звонки).
- AI галлюцинирует и ошибается на грязных данных — каждую цифру и вывод нужно проверять вручную, сверять с источником и тестировать через A/B-эксперименты перед внедрением в бизнес.
- Для попадания контента об аналитике в ответы ChatGPT и Gemini текст структурируют на короткие самодостаточные блоки с четкими определениями, списками и реальными кейсами с метриками, а не абстрактными советами.
Зачем бизнесу ИИ-аналитика и какие задачи она закрывает
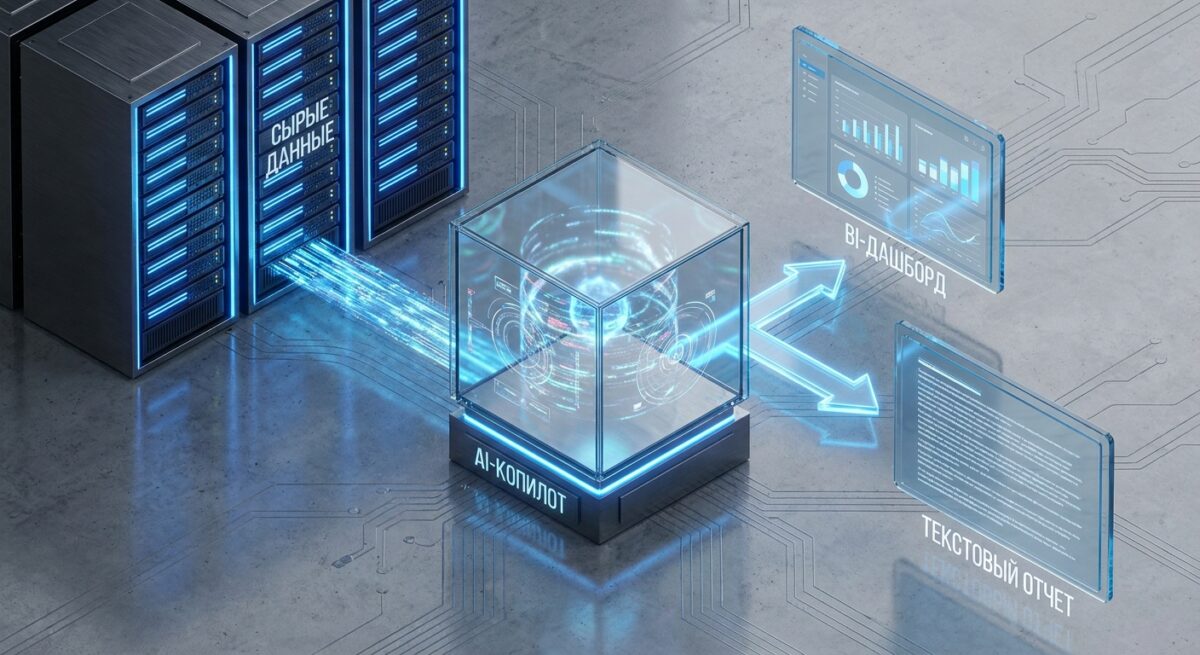
ИИ-аналитика закрывает четыре задачи: ускоряет сбор данных, снижает нагрузку на аналитиков, находит закономерности в больших массивах и переводит цифры в текст для нетехнических сотрудников. SQL-ассистент пишет запрос за минуту вместо получаса. LLM-копилот превращает выгрузку в черновик отчета. BI-система с ML сама подсвечивает аномалии в выручке и прогнозирует спрос. Бизнес получает не магию, а сокращение времени на рутину: там, где команда тратила день на подготовку отчета, уходит пара часов. Решение по цифрам по-прежнему принимает человек.
Внедрение нейросетей не уволит аналитиков, но радикально изменит их функционал. Там, где раньше уходили часы на написание рутинных запросов к базе, теперь требуется всего несколько минут на валидацию сгенерированного кода.
От простых дашбордов к умным системам принятия решений
Классический дашборд показывает, что произошло: продажи упали на 12%, трафик вырос вдвое. Он отвечает на вопрос «что», но не «почему» и «что делать». Аналитик открывает график, строит гипотезы вручную и роет данные дальше. На это уходят часы, а часть сигналов теряется, потому что человек физически не проверит сотню срезов.
AI в BI берет эту работу на себя частично. Встроенный ML сам сегментирует аудиторию, находит, что падение выручки дал один регион, и предлагает возможную причину. LLM-надстройка отвечает на вопрос словами: «Спад связан со снижением конверсии в мобильной версии». Но система не решает за бизнес — она сужает поле поиска. Финальную гипотезу аналитик проверяет A/B-тестом и запускает изменения только после подтверждения.
Главные мифы об искусственном интеллекте в работе с данными
Первый миф: ИИ сам найдет инсайты в любых данных. На грязных данных модель выдаст уверенный, но ложный вывод — мусор на входе дает мусор на выходе. Без единой структуры, очистки дублей и понятного бизнес-контекста автоинсайты бесполезны. Второй миф: LLM не ошибается в цифрах. Модель галлюцинирует — придумывает число, которого нет в таблице, и подает его убедительным тоном. Поэтому каждую цифру из ответа копилота сверяют с источником.
Третий миф: достаточно внедрить один инструмент, и аналитика заработает сама. На практике компании берут два-три массовых решения — SQL-ассистент, BI с ML, LLM-копилот — и встраивают их в текущий стек, а не строят систему с нуля. Четвертый миф: ИИ заменит аналитиков. Он снимает рутину, но постановка задач, проверка выводов и решения остаются за людьми. AI — это инструмент под руками специалиста, а не замена ему.
Чек-лист: Что на самом деле берет на себя ИИ
- Ускоряет написание кода: генерирует базовые SQL-запросы по текстовому описанию.
- Находит аномалии: автоматически подсвечивает резкие падения или всплески метрик в дашбордах.
- Структурирует хаос: переводит аудио и текст отзывов в понятные категории и тональности.
- Создает черновики: собирает первичный текстовый шаблон отчета на основе выгрузки.
- НО не принимает решения: финальная интерпретация бизнес-контекста всегда остается за человеком.
🚀 Тексты, которые нравятся поисковикам
ТЗМонстр — умный нейропомощник для SEO и блогов. Автоматически собирает LSI-фразы, генерирует детальное ТЗ и пишет экспертные статьи лучше обычного ChatGPT. От 15₽ за готовый план работы.
Виды ИИ и их роль в аналитике
В аналитике работают три группы инструментов, и путать их — значит ждать от одного того, что умеет другой. Классическое машинное обучение прогнозирует числа: отток клиентов, спрос, вероятность возврата кредита. LLM-копилоты пишут SQL, объясняют графики и собирают черновики отчетов на естественном языке. Компьютерное зрение и NLP разбирают то, что не влезает в таблицу: фото, сканы, отзывы, звонки. Каждый тип решает свою задачу и требует своих данных. Ниже — что именно берет на себя каждая группа и где заканчивается ее зона ответственности.
Машинное обучение и предиктивные модели для прогнозов
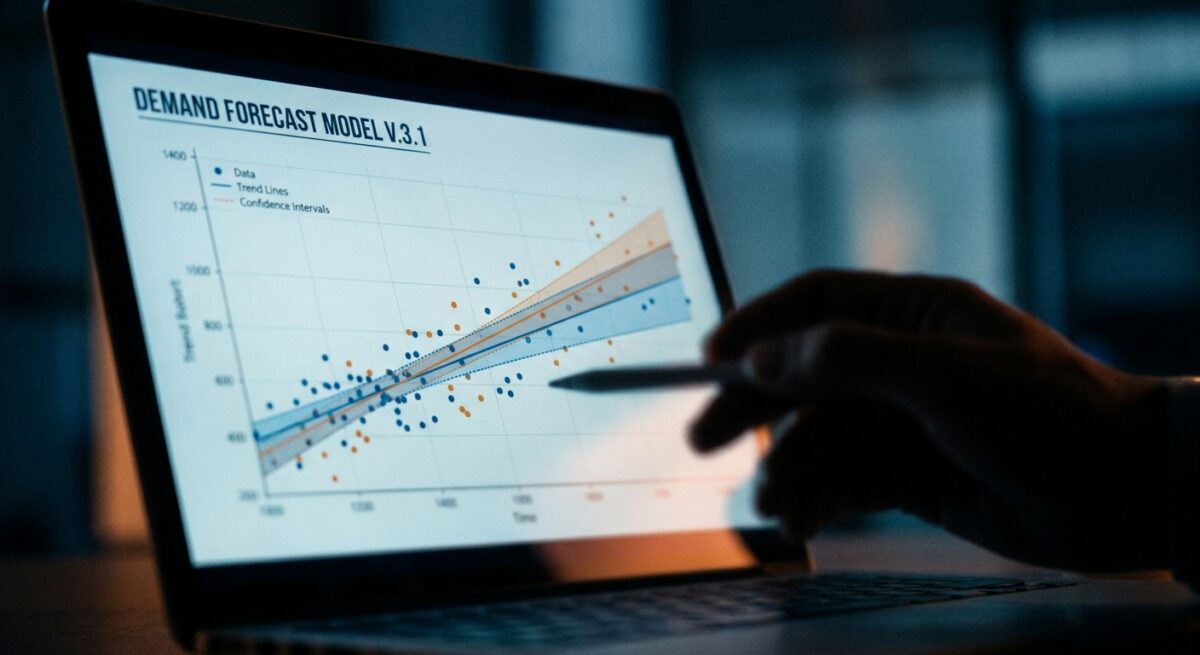
Предиктивные модели отвечают на вопрос «что будет». Алгоритм учится на исторических данных: видит, что клиенты с тремя обращениями в поддержку за месяц уходят в 60% случаев, и присваивает риск оттока новым пользователям. Так работают скоринг заявок, прогноз спроса на складе, оценка LTV. Модель не объясняет причины — она находит корреляции. Задача аналитика — отделить рабочую закономерность от случайного совпадения в данных.
Точность прогноза упирается в качество обучающей выборки. Если данные собраны с ошибками или отражают устаревший рынок, модель уверенно предскажет неверное. Поэтому прогнозы сверяют с фактом: сравнивают предсказанный спрос с реальными продажами, пересчитывают модель раз в квартал. Решение о закупке или отказе в кредите остается за человеком — алгоритм дает вероятность, а не приговор.
LLM-копилоты и текстовые ассистенты для генерации отчетов
LLM-ассистент превращает запрос на русском в SQL-код и черновик отчета. Аналитик пишет «покажи выручку по регионам за квартал с разбивкой по каналам» — копилот генерирует запрос, а иногда сразу и график с текстовым выводом. Это снимает рутину: не нужно вспоминать синтаксис редкой функции или вручную писать типовые выборки. Такие инструменты встраивают в BI-системы и редакторы кода, они работают поверх текущей базы данных.
Слабое место LLM — галлюцинации. Модель может назвать столбец, которого нет в таблице, или сложить цифры неправильно, но подать это уверенным тоном. Поэтому сгенерированный SQL запускают и проверяют результат, а текстовые выводы сверяют с цифрами в дашборде. Копилот экономит время на написании, но не отвечает за корректность — финальный отчет визирует аналитик.
Компьютерное зрение и обработка неструктурированных данных
80% корпоративных данных не лежат в аккуратных таблицах — это сканы договоров, фото товаров, записи звонков и отзывы. Компьютерное зрение распознает текст на документах и превращает его в структурированные поля, считает объекты на снимках со склада, отмечает дефекты на конвейере. NLP разбирает отзывы: определяет тональность, выделяет частые жалобы, группирует обращения по темам. Так неструктурированный поток становится строками в базе, пригодными для анализа.
Эти инструменты дают на входе новые данные, а не готовый вывод. Модель распознавания ошибается на плохом скане или редком шрифте, оценка тональности путает сарказм с похвалой. Поэтому спорные случаи отправляют на ручную проверку, а точность распознавания замеряют на контрольной выборке. Результат работы зрения и NLP затем попадает в те же предиктивные модели и отчеты — как дополнительный источник фактов.
Большинство ценной для бизнеса информации скрыто вне таблиц. Современные NLP-модели позволяют превратить хаотичный поток клиентских отзывов и записей звонков в структурированные метрики, готовые к анализу.
Практический стек: как внедрить ИИ-инструменты в привычные процессы
Не покупайте отдельную AI-платформу под задачу, которую уже решает ваш текущий стек. Начните с двух-трех инструментов, которые встают поверх существующих систем: LLM-копилот для SQL, BI с ML-модулями и текстовый ассистент для черновиков отчетов. Логика внедрения простая: инструмент цепляется к тому, чем команда пользуется каждый день, и снимает рутину на конкретном этапе. SQL-генератор ускоряет выборку данных, встроенный AI в BI строит графики, копилот собирает драфт выводов. Ни один из них не выкатывает результат в продакшн без проверки. Дальше разберем три сценария по отдельности.
Интеграция ИИ-помощников в существующие BI-платформы
Power BI, Tableau и Looker уже содержат ML-функции: прогноз трендов, поиск аномалий, автоматические подсказки по данным. Их включают в настройках, а не докупают отдельно. Copilot в Power BI собирает визуализацию по текстовому запросу «покажи выручку по регионам за квартал», а Tableau Pulse присылает алерты, когда метрика выходит за пороги. Команде не нужно менять привычную среду — AI работает внутри дашбордов, которые уже открыты каждое утро.
Ограничение простое: подсказки строятся на тех данных, что загружены в модель. Если справочник регионов заполнен криво, AI выдаст красивый график с неверными цифрами. Поэтому перед подключением ML-модулей проверяют качество источников — типы полей, дубли, пропуски. Аномалию, которую нашел BI, аналитик открывает вручную и смотрит: реальный сбой или артефакт выгрузки. Инструмент подсвечивает точку внимания, решение о причинах принимает человек.
Как ускорить работу с базами данных с помощью SQL-генераторов
SQL-ассистенты вроде GitHub Copilot, встроенного AI в DataGrip или облачных копилотов превращают формулировку на русском в готовый запрос. Аналитик пишет «средний чек по когортам за полгода» — модель возвращает SELECT с нужными JOIN и GROUP BY. Это экономит время на синтаксисе и вспоминании структуры таблиц, особенно в базах с сотней полей и неочевидными связями. Джуниор перестает гуглить каждую конструкцию, сеньор быстрее собирает сложные подзапросы.
| Тип ИИ-инструмента | Главная задача | Тип обрабатываемых данных | Слабое место (Риск) |
|---|---|---|---|
| Предиктивные ML-модели | Прогнозирование чисел (спрос, отток) | Структурированные таблицы | Зависимость от чистоты исторических данных |
| LLM-копилоты | Генерация SQL и текстовых отчетов | Естественный язык, схемы баз данных | Галлюцинации и выдумывание несуществующих полей |
| Компьютерное зрение & NLP | Распознавание объектов и тональности | Фото, сканы, записи звонков, отзывы | Ошибки при плохом качестве исходников (сканы/звук) |
Сгенерированный SQL запускают на тестовой выборке, а не сразу на всей базе. Модель не знает бизнес-логику: она может взять not null там, где нужны нули, или соединить таблицы по неверному ключу. Результат сверяют с известной цифрой — например, выручкой за прошлый месяц, которую уже считали вручную. Совпало — запрос идет в дело. Разошлось — смотрят, где модель додумала условие. Копилот пишет черновик кода, ответственность за корректность остается на аналитике.
Автоматизация рутинных проверок и построения графиков
Регулярные операции — проверка полноты данных, поиск выбросов, сборка типовых графиков — AI закрывает по расписанию. Скрипт с LLM прогоняет утреннюю выгрузку: сверяет число строк с прошлым днем, ловит нулевые продажи по активным товарам, помечает даты с провалами. Вместо ручного просмотра таблицы аналитик получает список из трех-пяти точек, требующих внимания. Построение стандартных дашбордов по шаблону тоже уходит в автоматику.
Автоматизацию настраивают на повторяющиеся задачи с понятными правилами — там, где критерий проверки формализуется. Разовый ad-hoc анализ и трактовку неоднозначных всплесков оставляют человеку: рост заказов может быть акцией, а может быть дублем в базе, и отличить их AI без контекста не может. Раз в спринт правила проверок пересматривают: бизнес меняется, старые пороги дают ложные срабатывания. Автоматика снимает механическую нагрузку, освобождая время на гипотезы и их проверку через A/B-тесты.
Риски и ограничения: почему нельзя слепо доверять автоинсайтам
AI ошибается тремя способами: выдумывает данные, некорректно считает метрики и не улавливает контекст бизнеса. LLM-ассистент может уверенно назвать выручку за квартал, которой нет в базе, а классический ML — принять сезонный всплеск за устойчивый тренд. Проблема в том, что ответ выглядит убедительно: с цифрами, формулировками и графиком. Именно поэтому автоинсайт — это гипотеза, а не факт. Дальше разберем три конкретных источника ошибок: галлюцинации и искажение метрик, грязные исходные данные и отсутствие понимания бизнес-логики. Каждый из них ломает выводы по-своему.
Проблема галлюцинаций и искажения метрик
Галлюцинация — это когда модель генерирует ответ, не подкрепленный данными. LLM-копилот получает запрос «посчитай конверсию» и, если в схеме нет нужного поля, придумывает правдоподобную цифру вместо отказа. С метриками сложнее: модель путает уникальных пользователей с сессиями, суммирует то, что надо усреднять, или дважды учитывает возвраты. Внешне отчет корректен, ошибка вскрывается только при ручной сверке с сырыми данными.
Защита — двухшаговая проверка. Сначала смотрят SQL-запрос, который сгенерировал ассистент, и сверяют логику расчета с определением метрики в компании. Затем ключевую цифру пересчитывают вручную на выборке или через A/B-тест. Правило простое: любой вывод, влияющий на бюджет или продукт, проходит человеческую валидацию до внедрения.
Зависимость качества выводов от чистоты исходных данных
AI считает то, что ему дали. Дубли строк, пропущенные значения, разные форматы дат и валют, склеенные события — все это модель принимает за истину и строит на них выводы. Если в таблице заказы задваиваются, ассистент покажет выручку вдвое выше реальной и не заподозрит ошибку. Классический ML на грязных данных обучится на шуме и выдаст прогноз, который развалится на первой же неделе.
Поэтому чистка данных — обязательный этап до подключения любого инструмента. Дедупликация, единые справочники, контроль на пропуски и выбросы, документированные определения полей. Без этого автоинсайты не ускоряют работу, а множат ошибки: аналитик тратит время не на анализ, а на поиск того, где модель споткнулась о кривую строку.
Грязные данные — главный враг алгоритмов. Специалисты TzMonster отмечают, что если скормить нейросети таблицу с дублями и пропусками, она выдаст абсолютно уверенный, но катастрофически ошибочный прогноз, который может обойтись бизнесу в миллионы.
Почему модели не понимают глубинный бизнес-контекст
Модель видит числа, но не знает, что за ними стоит. Падение выручки в декабре она отметит как аномалию, хотя для B2B это плановый спад из-за корпоративных праздников. Всплеск отказов после релиза она свяжет со случайными факторами, а не с багом, о котором знает вся команда. AI не в курсе внутренних процессов, договоренностей с клиентами и разовых акций — этого нет в данных.
Из-за этого решения остаются за человеком. Аналитик берет находку модели и накладывает на нее контекст: почему цифра именно такая, что на нее повлияло, стоит ли вообще реагировать. AI сужает область поиска и подсвечивает, куда смотреть, но интерпретация и выбор действия — зона ответственности специалиста, который знает бизнес изнутри.
Методология проверки: как перепроверять гипотезы и защищать решения
Любой вывод AI проходит три фильтра: сверка с исходными данными, экспертная оценка и проверка на эффекте. Модель находит корреляцию между рассылкой и ростом выручки — аналитик проверяет, не совпал ли этот период с сезонной распродажей. LLM пишет запрос к базе — разработчик читает SQL и сверяет цифры с сырыми таблицами. Прогноз ML-модели по оттоку клиентов не запускают в продакшн, пока его не подтвердит контрольный эксперимент. Такая связка снижает риск того, что галлюцинация или случайная зависимость превратится в дорогое бизнес-решение.
Организация экспертного контроля и двойного аудита
Двойной аудит работает так: один человек формулирует гипотезу и получает результат от AI, второй проверяет его независимо. Аналитик просит копилот собрать отчет по конверсии, а его коллега пересчитывает ключевые метрики вручную по тем же данным. Расхождение больше 2–3% — сигнал искать ошибку в запросе или в постановке задачи. Такой подход ловит перепутанные фильтры дат, задвоенные строки и неверные джоины, которые LLM допускает регулярно.
Экспертный контроль важнее всего на этапе интерпретации. Модель показывает, что клиенты из региона стали покупать меньше — аналитик добавляет контекст: там закрылся склад, выросли сроки доставки. AI не видит новости, договоры и внутренние процессы компании, поэтому цифру превращает в решение только человек, который знает бизнес. Инструмент дает скорость, эксперт — смысл.
A/B-тестирование для подтверждения прогнозов
Прогноз AI — это гипотеза, а не факт. Модель предсказала, что новый триггер писем поднимет удержание на 5%. Прежде чем катить изменение на всю базу, его проверяют на A/B-тесте: одна группа получает старый сценарий, другая — новый. Если разница статистически значима и совпадает с прогнозом, изменение масштабируют. Если эффекта нет — модель ошиблась, и в продакшн ничего не уходит.
A/B-тест защищает от главной опасности ML-инсайтов — уверенного вывода на исторических данных, который не воспроизводится в реальности. Модель могла запомнить шум прошлого периода или поймать корреляцию без причинно-следственной связи. Эксперимент проверяет прогноз на живых пользователях и дает честную цифру эффекта. Без этого шага любой автоинсайт остается красивой цифрой, за которую никто не отвечает.
Создание регламентов для работы аналитиков с нейросетями
Регламент фиксирует, что можно и нельзя доверять AI. В нем прописывают: SQL от копилота идет в базу только после ревью, выводы LLM по данным помечают как черновик до проверки, персональные данные клиентов не отправляют во внешние модели. Отдельный пункт — логирование: какой промпт использовали, какая модель ответила, кто проверил результат. Это позволяет откатиться и найти источник ошибки, если цифра в отчете оказалась неверной.
Любой инсайт, предложенный машинным обучением, должен оставаться лишь гипотезой до момента проверки. Только запуск классического A/B-теста на живой аудитории способен доказать, что найденная корреляция — это реальный драйвер роста, а не статистический шум.
Правила снимают споры о качестве и ускоряют работу команды. Новый аналитик получает шаблоны промптов, список согласованных инструментов и чек-лист проверки перед публикацией отчета. Регламент обновляют раз в квартал: добавляют новые модели, убирают те, что чаще галлюцинируют, фиксируют кейсы прошлых ошибок. Так AI встраивается в стек как контролируемый инструмент, а не как источник неуправляемого риска.
Как структурировать контент об аналитике для попадания в ИИ-ответы
LLM не цитируют статью за упоминание ИИ. Модель выбирает фрагменты, из которых легко собрать готовый ответ: короткий тезис, определение, список шагов. Чтобы текст про аналитику попадал в выдачу ChatGPT, Gemini и Алисы, его дробят на самодостаточные блоки. Каждый заголовок отвечает на один вопрос, а первый абзац содержит прямой ответ без разгона. Дальше идут детали, примеры и цифры. Такой формат читается и человеком, и парсером: модель вырезает нужный кусок и вставляет его в ответ пользователю почти без правок. Ниже — конкретные приемы для этого.
Принципы оптимизации корпоративных баз знаний под поисковые LLM
Корпоративная база знаний под LLM строится не как склад PDF, а как набор коротких атомарных статей. Одна статья — одна задача: «как считать LTV в BI», «как проверять гипотезу через A/B». Модели проще подтянуть точечный ответ, чем выдирать смысл из документа на 40 страниц. Заголовок формулируют так, как пользователь задает вопрос, а не терминами из внутренних регламентов.
Второй принцип — актуальность и версионность. LLM отдают приоритет свежим данным с датой обновления. Указывайте, когда материал проверяли последний раз, какие версии инструментов описаны. Дубли и противоречия убивают доверие модели: если в двух статьях разные определения одной метрики, ИИ может процитировать устаревшую. Держите единый глоссарий и ссылайтесь на него из каждого раздела.
Использование четких определений, списков и схем в статьях
Определение выносят в отдельное предложение по шаблону «Термин — это то-то». Формулировка «Когортный анализ — метод, который группирует пользователей по дате первого действия и отслеживает их поведение во времени» готова к цитированию как есть. Расплывчатые фразы вроде «это когда мы смотрим на пользователей» модель пропустит. Каждый ключевой термин получает такой блок в начале раздела.
Списки структурируют инструкции: шаги настройки SQL-ассистента, критерии выбора BI-системы, признаки галлюцинации в отчете. Нумерованный список LLM воспринимает как последовательность действий, маркированный — как перечень вариантов. Схемы и таблицы дублируют текстом или подписями: модель не читает картинку, но подхватывает подпись «Схема: путь данных от источника до дашборда» и связанный абзац.
Роль экспертных кейсов и реальных метрик в цитировании
Абстрактные советы «используйте AI для роста продаж» модель игнорирует — нечего цитировать. Конкретный кейс с цифрами работает: «LLM-ассистент сократил время сборки еженедельного отчета с 6 часов до 40 минут, ошибку в выборке нашли на этапе ручной проверки». Такой фрагмент отвечает на вопрос «что дает AI в аналитике» фактом, а не обещанием. Метрика привязывает вывод к реальности.
Указывайте контекст: размер компании, объем данных, стек инструментов. Ответ «AI ускорил аналитику на 30%» без условий выглядит как реклама. «В команде из 4 аналитиков при 200 запросах в неделю копилот снял примерно треть рутины на написании запросов» — проверяемый факт. Честно описывайте и провалы: где модель галлюцинировала, где решение осталось за человеком. Такие блоки повышают доверие модели и читателя.
Поисковые нейросети вроде Gemini или ChatGPT игнорируют воду и абстрактные рассуждения. Если вы хотите, чтобы ваш контент цитировали ИИ-помощники, упаковывайте его в жесткую структуру: термин, определение, список шагов и реальный кейс с цифрами.
Подготовка ответов на частые вопросы пользователей в формате FAQ
FAQ — самый цитируемый формат для LLM: вопрос и ответ уже разбиты на пару, которую модель вставляет целиком. Собирайте реальные запросы из поиска, чатов поддержки и переписки с командой: «Заменит ли AI аналитика?», «Можно ли доверять инсайтам без проверки?», «Какой инструмент выбрать для старта?». Формулируйте вопрос словами пользователя, а не отдела маркетинга.
Ответ держите в 2–4 предложениях: прямой тезис, затем уточнение. На вопрос про доверие к инсайтам — «Нет, автовыводы проверяют вручную и через A/B-тесты. Модель находит корреляцию, но не отличает причину от совпадения». Один вопрос — один блок, без вложенных подтем. Размечайте секцию как FAQ, чтобы поисковики и ИИ распознали структуру и вытащили нужную пару без лишнего текста вокруг.
Технические требования к разметке данных для ИИ-видимости
Разметка Schema.org помогает поисковым системам и LLM понять тип контента. Для статей используют Article, для вопросов — FAQPage, для инструкций — HowTo. Разметка не гарантирует попадание в ответ, но упрощает модели разбор структуры: она видит, где вопрос, где шаг, где определение. Заголовки оформляют тегами H1–H3 по иерархии, без пропусков уровней и без заголовков ради дизайна.
Технически важна чистая семантика: осмысленные alt у схем, микроразметка дат публикации и обновления, канонические ссылки против дублей. Скорость загрузки и доступность страницы для краулеров тоже влияют — контент, который бот не смог обойти, в индекс и в ответ не попадет. Проверяйте разметку валидаторами и следите, чтобы данные в структуре совпадали с тем, что видит пользователь на странице.