«Конкурентная нейросеть» — это миф. Нет волшебной кнопки, которая сама изучит соперников и выдаст готовую стратегию. За такими сервисами стоят обычные LLM вроде ChatGPT и Gemini плюс парсеры данных. Если просто запустить промпт без списка конкурентов и проверки цифр, ИИ начнет галлюцинировать. Рабочий подход другой: собрать сырые данные о трафике, ценах и семантике через Similarweb или Serpstat, выгрузить в таблицу и прогнать через нейросеть для анализа. В этой статье разберем весь пайплайн по шагам — от поиска соперников до промптов. Покажем и то, как оптимизировать страницы, чтобы ИИ цитировал именно ваш контент в ответах.
- AI-ответы в выдаче Google и Яндекса перехватывают до 40% кликов по информационным запросам — конкурентный анализ должен отслеживать, какие страницы соперников цитируют нейросети, а не только позиции в классической выдаче
- Нейросети не собирают данные сами и галлюцинируют без исходников — эффективный пайплайн: выгрузить сырые данные из Similarweb/Serpstat в таблицу, затем прогнать через LLM для кластеризации и анализа паттернов
- Чтобы попасть в AI-ответы, публикуйте контент с прямым ответом в первом предложении, добавляйте Schema.org разметку (FAQPage, HowTo, Article) и используйте конкретные цифры вместо общих фраз
- Разовый анализ бесполезен — встройте мониторинг конкурентов в регулярный цикл (раз в месяц), превращайте выводы в конкретные задачи с метриками и проверяйте результаты через дашборды и реферреры из нейросетей
Почему старый анализ конкурентов больше не работает и при чем здесь ИИ
Ручной сбор данных о конкурентах — скриншоты сайтов, подсчет ключевых слов в Excel, мониторинг цен раз в квартал — давал результат, когда поисковая выдача обновлялась медленно. Сейчас Google и Яндекс генерируют AI-ответы прямо в выдаче, а пользователи все чаще получают информацию из ChatGPT и Gemini, минуя сайты. Конкурентная среда сместилась: важно не только занять позицию в органике, но и попасть в источники, которые цитируют нейросети. Старая модель анализа не учитывает этот слой конкуренции, поэтому компании теряют трафик, даже оставаясь в топ-10 классической выдачи. Разберем, как перестроить подход.
Эволюция поиска: от ссылок к AI-ответам
До 2023 года путь пользователя был линейным: запрос → десять синих ссылок → клик → сайт. Сейчас Google SGE и Яндекс Нейро формируют развернутый ответ еще до списка ссылок. По данным аналитиков, AI-блоки перехватывают до 40 % кликов по информационным запросам. Это значит, что конкурент, чей контент попал в источник AI-ответа, забирает внимание аудитории даже при более низкой позиции в классической выдаче.
Конкуренция сместилась из «десяти синих ссылок» в AI-ответы Google и Gemini. Теперь важно не просто быть в топе, а стать источником, который цитирует нейросеть.
Параллельно растет доля людей, которые задают вопросы напрямую ChatGPT или Gemini вместо поисковика. Нейросеть выбирает источник по структуре текста, наличию фактов и схем, а не по количеству обратных ссылок. Для анализа конкурентов это критично: нужно отслеживать, какие страницы соперников цитируются в AI-ответах и почему, а не только смотреть позиции в выдаче.
Что нейросети реально умеют делать с данными конкурентов
LLM не умеют сами парсить сайты и получать актуальный трафик конкурента — это задача сервисов вроде Similarweb, Serpstat или маркетплейс-аналитики. Но когда сырые данные выгружены в таблицу, нейросеть справляется с тем, на что у аналитика уходят часы: кластеризация семантики по интентам, сравнение ценовых матриц, выявление паттернов в отзывах, генерация сводных отчетов с выводами.
Практический пример: выгрузите из Serpstat топ-500 ключей трех конкурентов, загрузите CSV в ChatGPT и попросите сгруппировать по потребностям аудитории, выделить запросы, которые покрывают все три сайта, и найти кластеры, где конкуренция минимальна. За 2–3 итерации промпта вы получите структуру, на которую вручную ушел бы целый рабочий день. Главное — проверить цифры в источнике, потому что LLM может округлить или исказить числа.
Развенчиваем мифы: что ИИ не заменит, а только усилит
Первый миф — существование «конкурентной нейросети», которая сделает все сама. На деле за любым таким сервисом стоит та же GPT-модель плюс парсер, обернутые в интерфейс. Без ручной формализации ниши, списка прямых соперников и проверки выгрузок анализ превращается в набор правдоподобных, но ложных утверждений. ИИ галлюцинирует, когда ему не хватает контекста, — и никакой промпт это не исправит.
Второй миф — что нейросеть заменяет маркетолога. LLM ускоряет рутину: кластеризацию, суммаризацию, черновики отчетов. Но стратегические решения — выбор сегмента, позиционирование, приоритеты по каналам — требуют экспертизы, знания рынка и здравого смысла. Рабочая связка выглядит так: человек ставит задачу и проверяет результат, нейросеть обрабатывает массив данных между этими двумя точками.
🚀 Тексты, которые нравятся поисковикам
ТЗМонстр — умный нейропомощник для SEO и блогов. Автоматически собирает LSI-фразы, генерирует детальное ТЗ и пишет экспертные статьи лучше обычного ChatGPT. От 15₽ за готовый план работы.
Строим пайплайн: как собрать и подготовить данные для нейросетей
Пайплайн конкурентного анализа через нейросеть состоит из четырех шагов: определить нишу и список соперников, собрать сырые данные из проверенных источников, выгрузить их в структурированную таблицу и отправить в LLM для кластеризации и выводов. Без первых трех этапов промпт превращается в лотерею: модель не имеет доступа к актуальным данным о трафике или ценах и начинает генерировать правдоподобные, но ложные цифры. Задача — дать нейросети факты, а не просить ее их выдумать. Разберем каждый шаг с конкретными инструментами и форматами.
Без четко очерченной ниши, географии и ценового сегмента нейросеть для анализа конкурентов превращается в генератор случайных, нерелевантных брендов.
На старте: как определить нишу и главных соперников
Прежде чем открывать ChatGPT, зафиксируйте три параметра: товарная категория или услуга, география и ценовой сегмент. Без этой рамки LLM выдаст список из случайных брендов. Практический прием — введите в Яндекс и Google 5–7 коммерческих запросов, по которым хотите ранжироваться, и выпишите домены из топ-10. Пересечения покажут реальных соперников, а не абстрактных лидеров рынка.
Оптимальное количество конкурентов для анализа — от 3 до 7. Меньше — не хватит данных для паттернов, больше — таблица разрастется, а выводы размоются. Разделите список на прямых конкурентов (тот же продукт, та же аудитория) и косвенных (другой формат, но перехватывают трафик). Этот список станет входной точкой для сбора метрик на следующем шаге.
Где брать сырые данные по SEO, трафику и ценам
Два базовых источника по трафику и семантике — Similarweb (бесплатная версия показывает оценку визитов, каналы и топ-ключевые слова) и Serpstat (кластеризация семантического ядра, видимость в поиске, обратные ссылки). Для российского рынка добавьте Keys.so или SpyWords — они точнее считают позиции в Яндексе. Данные по ценам берите напрямую: парсинг каталога конкурента через Octoparse или простой ручной скриншот прайс-листа.
- SEO и трафик (глобально): Similarweb, Serpstat.
- SEO и трафик (Россия): Keys.so, SpyWords.
- Цены: Прямой парсинг каталога (например, через Octoparse) или ручной сбор.
- Отзывы: Выгрузка с маркетплейсов (Ozon, Wildberries) и геосервисов.
- Рекламные креативы: Библиотека рекламы Meta, TikTok Creative Center.
Отзывы — отдельный пласт. Выгружайте их с маркетплейсов (Wildberries, Ozon) через встроенные фильтры или API. Рекламные креативы фиксируйте через Библиотеку рекламы Meta и TikTok Creative Center. Каждый источник сохраняйте в отдельный CSV или Google-таблицу с указанием даты сбора, чтобы нейросеть работала с актуальным срезом, а не с устаревшими цифрами.
Какие метрики собирать: от трафика до рекламы
Минимальный набор для каждого конкурента: ежемесячный трафик, доля органики и платных каналов, топ-20 ключевых запросов по видимости, количество обратных ссылок и доменов-доноров, средний чек или диапазон цен на ключевые товары. Эти пять метрик уже дают нейросети достаточно контекста для сравнительного анализа и поиска слабых зон.
Расширенный набор включает: частоту публикаций в блоге, среднюю длину статей, наличие FAQ-разметки и schema.org, рейтинг на маркетплейсах, тональность последних 50 отзывов и список рекламных офферов. Чем больше осей сравнения, тем точнее LLM выявит паттерны. Но не гонитесь за полнотой ради полноты — собирайте только те метрики, по которым готовы принимать решения и менять стратегию.
Как упаковать данные, чтобы нейросеть их поняла
LLM лучше всего работает с табличными данными в формате CSV или Markdown-таблиц, вставленных прямо в промпт. Каждая строка — конкурент, каждый столбец — метрика. Обязательно добавьте строку со своими собственными показателями: без точки отсчета модель не сможет сказать, где вы отстаете. Объем контекстного окна у GPT-4o — 128 000 токенов, у Gemini 1.5 — до миллиона, поэтому таблица на 5–7 конкурентов с 10 метриками поместится легко.
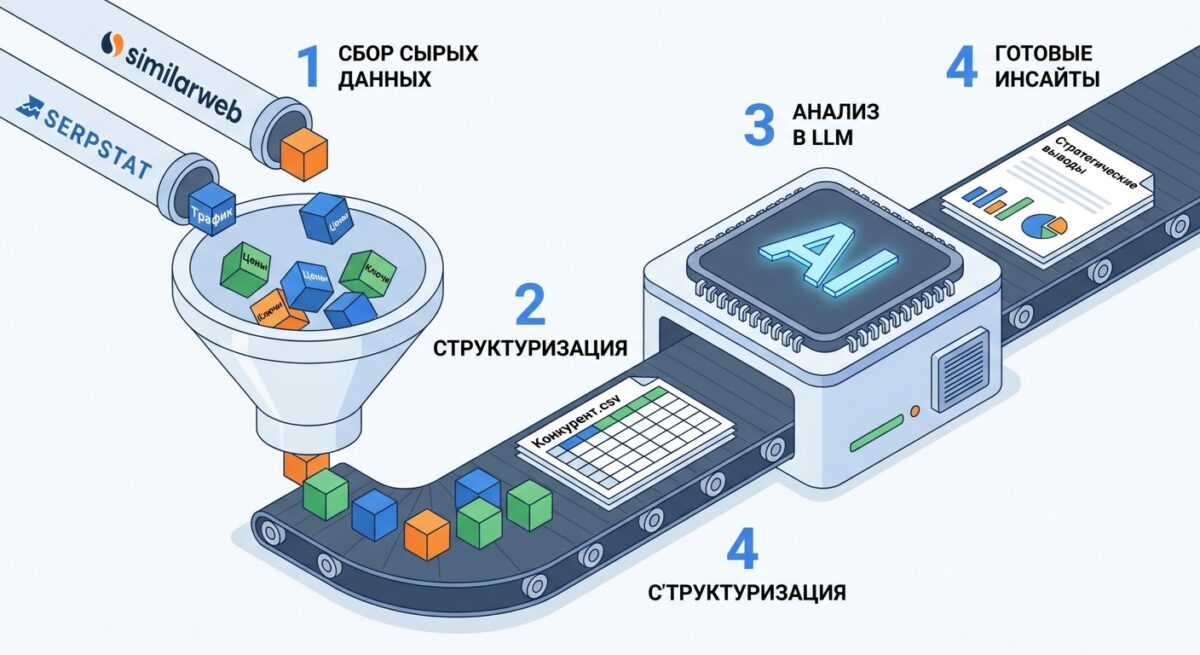
Перед вставкой очистите данные: уберите дубли, приведите числа к единому формату (тысячи без пробелов, цены в одной валюте), замените пустые ячейки на «н/д». Грязные данные — главная причина галлюцинаций при анализе. После очистки добавьте к таблице короткую преамбулу: название ниши, география, дата сбора. Такой пакет готов к передаче в промпт на этапе анализа.
Достаем инсайты: как заставить LLM работать с чужой аналитикой
LLM не собирает данные о конкурентах сама — обрабатывает то, что вы ей дали. Сначала выгружаете сырье: трафик из Similarweb, ключевые запросы из Serpstat, цены и отзывы с маркетплейсов. Дальше нейросеть кластеризует эти данные, ищет закономерности и сводит выводы в таблицу. Без исходников на входе ChatGPT выдумает цифры и назовет несуществующие компании лидерами рынка. Логика простая: человек формализует нишу и проверяет факты, ИИ ускоряет рутину — группировку, сравнение и черновую сводку. Разберем каждый этап: от выбора ассистента до поиска слабых мест соперников.
Выбираем ИИ-ассистента под большие тексты
Для анализа конкурентов важен объем контекста — сколько данных модель удержит за один запрос. Gemini 1.5 Pro работает с окном до 1–2 млн токенов, туда влезает выгрузка семантики на тысячи строк. ChatGPT в версии с расширенным контекстом берет до 128 тысяч токенов — хватит для сравнения 5–10 сайтов по ключевым метрикам. Claude держит около 200 тысяч токенов и аккуратно работает с таблицами.
Выбор зависит от задачи. Нужно прогнать выгрузку из Serpstat на 50 тысяч запросов — берите Gemini с большим окном. Сравниваете структуру десяти лендингов и тексты офферов — подойдет ChatGPT или Claude. Проверяйте, что сервис читает загруженные файлы: CSV и XLSX модели разбирают точнее, чем текст, вставленный простыней в чат.
Для анализа выгрузки семантики на 50 000 ключей нужен Gemini 1.5 Pro, а для сравнения десятка лендингов хватит и ChatGPT. По опыту компании TzMonster, выбор правильного инструмента под конкретную задачу важнее, чем погоня за самым большим контекстным окном.
Пишем идеальные промпты для разбора чужих стратегий
Промпт без роли и структуры дает размытый ответ. Задайте контекст: «Ты маркетолог-аналитик. Вот выгрузка трафика трех конкурентов в нише доставки еды. Определи, кто растет, за счет каких каналов и запросов». Прикрепите данные и укажите формат вывода — таблица, список гипотез или короткое резюме. Чем конкретнее задача, тем меньше воды в ответе.
Разбивайте анализ на шаги вместо одного гигантского запроса. Сначала — «сгруппируй запросы по интентам», затем — «найди темы, где у конкурента много трафика, а у меня страницы нет», потом — «предложи заголовки под эти темы». Просите модель показывать источник каждого вывода: если она не может сослаться на строку из данных — это домысел, который нужно вычеркнуть.
Ищем паттерны в чужом контенте с помощью ИИ
Соберите 10–20 топовых статей конкурента и загрузите в модель. Попросите выделить общую структуру: сколько подзаголовков, какие блоки повторяются, где стоят таблицы и списки, есть ли FAQ. ИИ быстро покажет шаблон, по которому соперник собирает страницы в топ — например, ответ в первом абзаце плюс пошаговая инструкция плюс блок вопросов.
| ИИ-ассистент | Максимальный объем контекста | Оптимальная задача |
|---|---|---|
| Gemini 1.5 Pro | ~1-2 млн токенов | Анализ больших выгрузок данных (например, семантическое ядро на 50 000+ ключей). |
| ChatGPT (GPT-4o) | ~128 тыс. токенов | Сравнительный анализ 5-10 сайтов, разбор структуры контента, генерация гипотез. |
| Claude 3 | ~200 тыс. токенов | Работа с табличными данными, суммаризация больших документов, точное извлечение фактов. |
Дальше анализируйте смысловое наполнение. Промпт: «Какие подтемы раскрывают все конкуренты, а какие — только один?» Так находите пробелы: темы, которые нужно закрыть обязательно, и ниши, где можно обойти соперников за счет глубины. Проверяйте выводы вручную — модель иногда объединяет разные по смыслу абзацы в один «паттерн», которого на деле нет.
Как нейросети помогают найти чужие УТП и слабые места
Отзывы — главный источник слабых мест. Выгрузите оценки с маркетплейсов или Яндекс.Карт и попросите ИИ сгруппировать жалобы: долгая доставка, скрытые платежи, плохая поддержка. Модель посчитает частоту претензий и покажет, где конкурент проседает. Эти дыры — ваши точки роста: то, что раздражает клиентов соперника, вы закрываете в своем оффере.
Для поиска УТП загрузите тексты с их сайтов и рекламных объявлений. Запрос: «Выпиши обещания и выгоды, которые конкурент повторяет чаще всего». Так видно, на что они делают ставку — на цену, скорость или гарантию. Сравните с собственным позиционированием и найдите свободную формулировку. Не берите выводы на веру: сверьте цены и условия на самих сайтах, потому что ИИ мог зацепить устаревший кэш.
От инсайтов к стратегии: внедряем выводы и не делаем ошибок
Собранные данные о конкурентах бесполезны, пока лежат в таблице. Ценность появляется, когда вы превращаете их в конкретные действия: закрываете пробелы в семантике, корректируете цены, добавляете разделы, которых нет у соперников. Возьмите три-пять выводов из ИИ-анализа и переведите каждый в задачу с ответственным и сроком. Например: конкурент собирает трафик по 200 информационным запросам, которых нет у вас — планируете кластер статей на квартал. Дальше важно не бросать анализ после первого прогона, а встроить его в регулярный цикл и проверять, дают ли изменения результат.
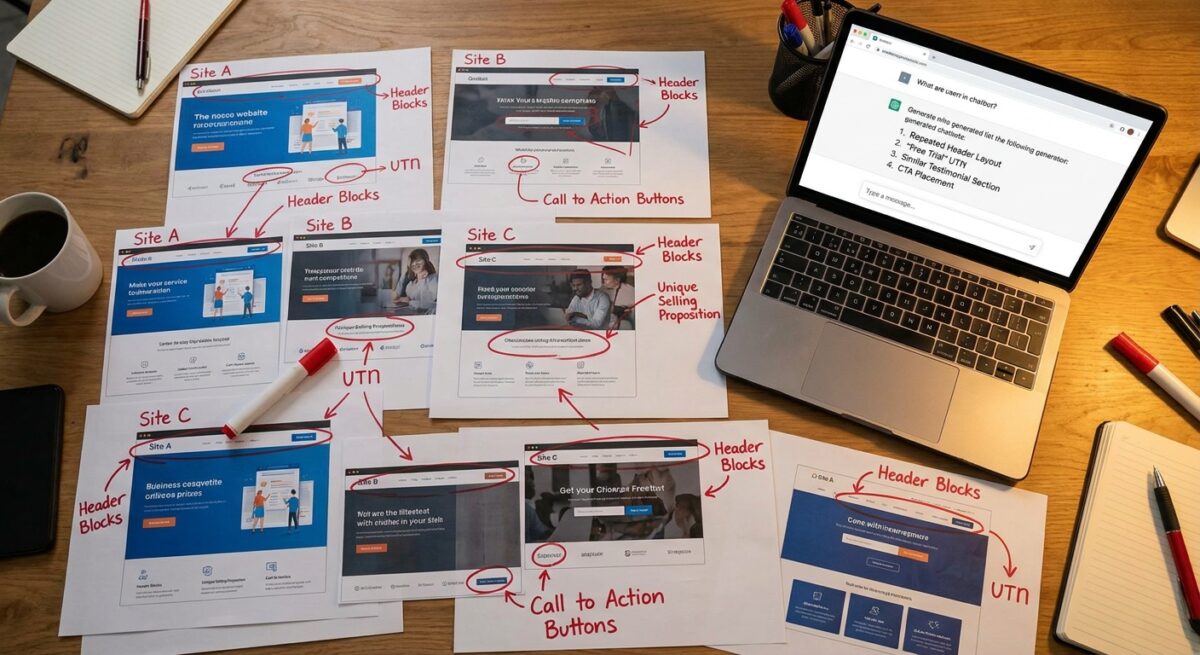
Как перенести чужие находки в свой план и не слезать с мониторинга
Разбейте выводы по приоритету через простую матрицу: усилие для внедрения против влияния на результат. Быстрые правки с высоким эффектом — добавить FAQ, переписать заголовки, закрыть очевидные пробелы в ценах — берите в работу первыми. Крупные задачи вроде нового раздела сайта или пересмотра линейки товаров ставьте в бэклог с оценкой ресурсов. Каждую задачу привязывайте к метрике: позиция по запросу, доля показов, конверсия. Без цифры до старта вы не поймете, сработала правка или нет.
Мониторинг превращает разовый анализ в систему. Раз в месяц повторяйте сбор данных по тем же конкурентам и сравнивайте динамику: кто вырос в трафике, кто добавил новые страницы, кто изменил цены. Заведите дашборд с ключевыми показателями — так вы заметите сдвиг раньше, чем он ударит по вашим продажам. Промпты для сводки сохраните и переиспользуйте, чтобы отчеты были сопоставимы между периодами.
Типичные ошибки при работе с ИИ-аналитикой
Главная ошибка — доверять цифрам нейросети без проверки. LLM не знает актуальный трафик конкурента, оперирует тем, что вы дали на вход. Если скормить пустой запрос, модель выдумает правдоподобные, но ложные данные. Всегда подгружайте выгрузки из Similarweb или Serpstat и просите ИИ работать только с ними. Вторая ошибка — копировать чужую стратегию целиком. То, что работает у лидера с бюджетом в разы больше вашего, вас разорит.
Третья ловушка — анализ ради анализа. Отчет на двадцать страниц, который никто не читает и не внедряет, тратит время впустую. Ограничивайте вывод ИИ пятью-семью конкретными рекомендациями с приоритетом. И не путайте объем данных с их качеством: десять точных метрик по трем прямым конкурентам полезнее сотни цифр по случайным сайтам из выдачи. Отбирайте соперников вручную, не доверяйте этот шаг нейросети.
Главная ловушка AI-аналитики — анализ ради анализа. Если выводы не превращаются в конкретные задачи в Jira или Trello с дедлайнами и ответственными, вы просто потратили время на создание красивого, но бесполезного отчета.
Как попасть в AI-ответы и стать главным источником для нейросетей
ChatGPT, Gemini и AI-обзоры Google берут ответы из страниц, где данные структурированы и легко вычленяются. Чтобы нейросеть процитировала ваш анализ конкурентов, а не соседний сайт, страница должна отвечать на вопрос в первых строках, содержать конкретику — цифры, названия, сравнения — и быть размеченной так, чтобы алгоритм понял, где определение, где список, где вывод. Это тот же принцип, что вы применяли к анализу соперников: сначала сырые данные, потом чистая структура. Ниже — три технических рычага: понятный для модели текст, разметка Schema.org и проверка, действительно ли ИИ ссылается на вас.
Пишем понятный для LLM контент
Нейросеть вытаскивает ответ фрагментами. Если абзац начинается с вводных фраз, а суть спрятана в конце, модель его пропустит. Давайте прямой ответ в первом предложении блока: «Similarweb показывает трафик по каналам», а не «Существует множество инструментов, среди которых…». Дробите текст на короткие смысловые куски по 2–4 предложения. Каждый должен отвечать на один вопрос целиком, чтобы его можно было процитировать без остального контекста.
Добавляйте блок FAQ с реальными формулировками запросов: «Как собрать семантику конкурента», «Сколько стоит Serpstat». LLM охотно берут пары «вопрос–ответ» для генерации сводок. Используйте списки и таблицы для сравнений цен и функций — модель распознает их как готовые структурированные данные. И приводите конкретику: не «сервис дешевый», а «от 500 рублей в месяц». Цифры и названия — то, что ИИ цитирует в первую очередь.
Зачем нужна разметка Schema.org для видимости в ИИ
Schema.org — это микроразметка, которая объясняет алгоритму, что за данные на странице. Без нее нейросеть видит сплошной текст и угадывает структуру. С разметкой FAQPage она точно знает: вот вопрос, вот ответ. Разметка Article сообщает автора и дату, HowTo — что это пошаговая инструкция, Product — что здесь товар с ценой и отзывами. Такие сигналы повышают шанс, что фрагмент попадет в AI-обзор Google как проверенный источник.
Для статьи об анализе конкурентов подойдут три типа: FAQPage для блока вопросов, HowTo для пайплайна сбора данных, Article для всего материала. Внедряйте через JSON-LD в код страницы — это рекомендованный Google формат. Проверяйте результат в валидаторе Rich Results Test: он покажет, распознал ли поисковик разметку и нет ли ошибок. Без валидации разметка с опечаткой просто игнорируется, и эффекта не будет.
Тестируем выдачу: как понять, что ИИ цитирует именно вас
Задайте ChatGPT, Gemini и Perplexity те запросы, под которые писали статью: «как анализировать конкурентов через нейросеть», «лучшие сервисы для сбора семантики». Смотрите, появляется ли ваш бренд или ссылка в ответе. Perplexity и AI-обзоры Google показывают источники прямо под текстом — это самый наглядный способ проверить цитируемость. Фиксируйте результаты в таблице: запрос, сервис, есть ли упоминание, какая формулировка попала в ответ.
Если вас не цитируют, ищите причину в структуре. Сравните свой фрагмент с тем, что модель взяла у конкурента: возможно, у них ответ короче и стоит выше на странице. Повторяйте проверку раз в 2–3 недели — модели переобучаются, а AI-обзоры меняют источники. Отслеживайте переходы из нейросетей в аналитике по реферерам вроде chatgpt.com или perplexity.ai. Рост такого трафика — сигнал, что оптимизация под AI-ответы сработала.