Пользователь спрашивает у ChatGPT «как выбрать ноутбук» и получает готовый ответ — без единого клика на сайт, который этот ответ написал. Так работает AI-поиск: ChatGPT, Gemini, Claude и Perplexity собирают данные со сотен страниц, пересказывают их своими словами и отдают человеку прямо в чат. Клика по ссылке не происходит, а трафик, на который рассчитывал ваш сайт, испаряется. Это не будущее, а текущая реальность: конкуренты OpenAI и сама GPT‑4 уже перехватывают запросы, которые раньше шли через обычную выдачу. В статье разберем, как ИИ выбирает, что процитировать, какой контент страдает больше всего и что делать, чтобы попадать в ответы вместо того, чтобы терять аудиторию.
- AI-поиск (ChatGPT, Gemini, Claude, Perplexity) забирает до 40–60% трафика информационных запросов, пересказывая контент без кликов на источник — это уже текущая реальность, а не будущее
- Модели цитируют не объем текста, а структурированные фрагменты: заголовки-вопросы с ответом в первых строках, списки, таблицы и FAQ-блоки парсятся проще и попадают в ответы чаще
- Для попадания в ответы нужна переориентация на GEO (генеративную оптимизацию): явная привязка к бренду и нише, микроразметка Schema.org, факты вместо оценок, и тесты через реальные модели каждый месяц
- Российские сервисы (GigaChat, YandexGPT) работают с русскоязычным контентом и требуют другой стратегии, чем глобальные; контент с уникальной экспертизой, кейсами и интерактивом страдает от нулевого клика меньше всего
Анатомия AI-поиска: почему ChatGPT, Gemini и Claude лишают сайты кликов
Классический поиск работал по принципу «десять синих ссылок«: пользователь вводил запрос, получал список страниц и сам решал, куда перейти. Генеративные модели сломали эту цепочку. ChatGPT, Gemini, Claude и Perplexity читают десятки источников за секунду, синтезируют из них единый ответ и выдают его прямо в чат-интерфейсе. Пользователь получает готовое решение — без необходимости открывать хотя бы одну вкладку браузера. Для владельцев сайтов это означает конкретную проблему: контент используется как сырье для обучения и генерации, но визит на страницу-источник не фиксируется. Чтобы не просто потерять трафик, нужно начать получать упоминания и цитаты внутри AI-ответов.
Генеративные сети навсегда сломали привычный путь пользователя: теперь исчерпывающий ответ дается здесь и сейчас, без малейшей необходимости кликать по синим ссылкам в выдаче.
Как поисковые алгоритмы трансформируются в генеративные системы ответов
До 2023 года Google и Яндекс ранжировали страницы: оценивали релевантность, авторитетность и поведенческие факторы, а затем расставляли ссылки по позициям. Генеративная надстройка изменила архитектуру. Google SGE (теперь AI Overviews) пропускает топ-результаты через LLM и формирует сводный блок над органической выдачей. Яндекс встраивает нейросетевые саммари через YandexGPT. Перехватывается не один клик, а весь информационный запрос целиком.
Perplexity пошел дальше и вообще убрал классическую выдачу: модель генерирует ответ, а ссылки на источники выводит как сноски внизу. Claude и ChatGPT при веб-поиске действуют аналогично — парсят страницы, извлекают факты и пересказывают их в едином потоке. Алгоритм выбора источника стал непрозрачным: нет PageRank, нет привычных факторов ранжирования. Модель просто выбирает фрагменты текста по вероятности релевантности.
Почему пользователи перестали переходить по ссылкам в поисковой выдаче
Причина проста: AI-ответ закрывает информационную потребность быстрее, чем переход на сайт. Человек спрашивает «как рассчитать НДФЛ с дивидендов» и получает формулу, ставку и пример расчета за три секунды. Открывать статью на 2 000 слов, пролистывать рекламу и искать нужный абзац — лишний шаг. По данным SparkToro и Datos (2024), доля «zero-click«-запросов в Google превысила 60 %, и генеративные блоки ускоряют этот тренд.
Для контент-проектов это не абстрактная угроза, а измеримая просадка. Если раньше featured snippet забирал часть кликов, но оставлял ссылку на источник в выдаче, то AI Overview может вообще не содержать прямого URL. Пользователь удовлетворен, сайт-источник невидим. Остаться в поле зрения можно только одним способом: стать тем фрагментом, который модель процитирует с атрибуцией. Для этого нужно понимать, какой контент ИИ предпочитает «подхватывать».
Какие типы контента страдают от потери традиционного трафика больше всего
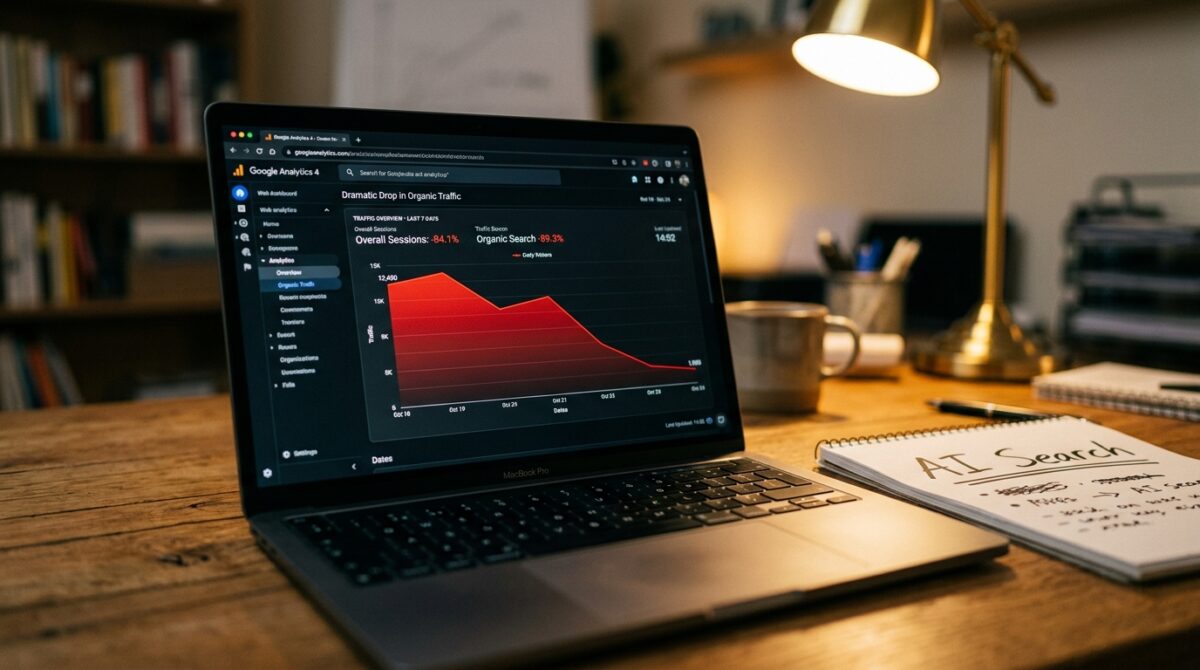
Первыми под удар попали информационные запросы с коротким однозначным ответом: определения, конвертации, формулы, даты, справочные таблицы. Страницы-глоссарии, калькуляторы и простые how-to-инструкции теряют до 40–60 % органического трафика после появления AI-блока в выдаче, потому что модель пересказывает их содержимое полностью и без остатка.
Следующая зона риска — обзоры и сравнения товаров. Когда пользователь спрашивает «лучший робот-пылесос до 30 000 рублей», Gemini или ChatGPT выдают топ-3 модели с ценами и плюсами-минусами, собранными из нескольких обзоров. Оригинальная статья-источник не получает визита. Меньше всего страдает контент с уникальной экспертизой, авторскими кейсами и свежими данными, которые модель не может пересказать без потери ценности — именно в эту сторону стоит сдвигать редакционную стратегию.
🚀 Тексты, которые нравятся поисковикам
ТЗМонстр — умный нейропомощник для SEO и блогов. Автоматически собирает LSI-фразы, генерирует детальное ТЗ и пишет экспертные статьи лучше обычного ChatGPT. От 15₽ за готовый план работы.
Главные конкуренты OpenAI на глобальном и локальном рынках
Рынок ИИ-ассистентов делится на два блока. Глобальный занимают Gemini от Google, Claude от Anthropic и поисковый агент Perplexity — каждый борется за роль основного интерфейса, через который люди получают ответы вместо перехода на сайты. Локальный российский сегмент держат GigaChat от Сбера и YandexGPT: они работают внутри страны без VPN и опираются на русскоязычные источники. Для владельца сайта важно не само наличие конкуренции, а то, что все эти сервисы по-разному собирают данные и по-разному решают, чей контент процитировать. Разберем каждого игрока и его логику отбора источников.
Обзор ключевых альтернатив в лице Gemini, Claude и поисковых агентов
Gemini связан с поисковым индексом Google, поэтому чаще подтягивает страницы, которые уже ранжируются в обычной выдаче, и добавляет к ответу ссылки на источники. Claude от Anthropic работает иначе: базовая версия отвечает по данным обучения без доступа к живому вебу, а веб-поиск подключается отдельно и цитирует ограниченный круг страниц. Попадание в ответ Claude сильнее зависит от того, насколько текст был распространен и переиспользован в интернете к моменту обучения модели.
Кратко: Как разные ИИ выбирают источники
- Gemini: Опирается на классический индекс Google, отдает предпочтение трастовым сайтам с хорошим ранжированием.
- Claude: Анализирует общую цитируемость бренда в сети, реже дает прямые ссылки на веб-поиск (в базовой версии).
- Perplexity: Ищет жесткую структуру (вопрос-ответ) в реальном времени, всегда ставит сноски на первоисточник.
- GigaChat / YandexGPT: Отдают безусловный приоритет русскоязычным доменам и локальному контексту.
Perplexity построен как поисковый агент: он в реальном времени сканирует веб под конкретный запрос, показывает пронумерованные ссылки и берет из них фрагменты. Это единственный из тройки, кто стабильно отдает кликабельные источники. Для сайта это значит: у Gemini и Perplexity шанс получить переход выше, чем у Claude. Критерий отбора — четкая структура и релевантность страницы конкретному вопросу пользователя.
Особенности работы российских экосистем GigaChat и Яндекс GPT
GigaChat и YandexGPT обучены преимущественно на русскоязычных данных, поэтому точнее обрабатывают запросы на русском и лучше понимают локальный контекст — цены в рублях, российские сервисы, региональные названия. YandexGPT встроен в Нейро и поисковую выдачу Яндекса: ответ формируется из проиндексированных страниц, рядом остаются ссылки на источники. Логика близка к Gemini — что хорошо ранжируется в Яндексе, то и попадает в цитирование.
GigaChat доступен через отдельный чат и API, работает без VPN и опирается на собственную базу источников Сбера. Для попадания в ответы обоих сервисов работает одно правило: контент на русском с явной привязкой к российским реалиям выигрывает у переводного или обобщенного. Если ваша аудитория внутри страны, эти две модели дают больше шансов на цитирование, чем зарубежные, у которых русскоязычные источники в приоритете ниже.
Чем отличаются модели цитирования у разных разработчиков ИИ
Ключевое различие — момент и способ обращения к источнику. Perplexity и Нейро берут данные под каждый запрос заново и показывают ссылки, поэтому свежесть и точность страницы влияют напрямую. Gemini смешивает поисковый индекс с обученными знаниями. Claude в базовом режиме отвечает по памяти обучения — там ссылок нет вовсе, и попасть можно только за счет широкого цитирования вашего материала другими ресурсами.
Разные ИИ-ассистенты работают по совершенно разным правилам: если Perplexity ищет жесткую структуру для цитирования, то Claude опирается на общую популярность бренда в сети.
Отсюда практический вывод: один и тот же текст разные модели подхватят по-разному. Под Perplexity и YandexGPT работает структура и релевантность конкретному вопросу, под Claude — распространенность и упоминаемость бренда в вебе. Универсальный контент, который цитируют все, — это статья с четкими заголовками-вопросами, кратким резюме в начале и явным указанием ниши. Такой формат легко вычленить и пересказать любому движку.
Анатомия генеративного ответа: что именно ИИ забирает с вашего сайта
ИИ не копирует страницу целиком. Он вытягивает отдельные фрагменты: определение из первого абзаца, три пункта из списка, строку из таблицы, один прямой ответ на вопрос из заголовка. Из этих кусков модель собирает финальный ответ пользователю. Значит, попадает в цитату не весь ваш текст, а конкретные блоки, которые легко вырвать из контекста и вставить в другой ответ. ChatGPT, Gemini и Claude по-разному режут контент, но принцип общий: они ищут самодостаточные смысловые единицы. Дальше разберем, по каким признакам нейросеть выбирает эти фрагменты и почему структура страницы решает больше, чем объем.
Как нейросети сканируют структуру страниц и выбирают фрагменты для цитат
Модель ориентируется на разметку и иерархию заголовков. H2 и H3 показывают ИИ границы смысловых блоков, а короткий абзац сразу под заголовком воспринимается как ответ на этот заголовок. Если между вопросом и ответом стоит три абзаца рассуждений, нейросеть теряет связь и берет фрагмент у конкурента, где ответ идет первой строкой. Perplexity дополнительно опирается на источники с чистой семантической структурой, потому что сверяет цитату с исходной страницей перед выводом.
Проверить это можно вручную. Задайте ChatGPT или Gemini свой типовой запрос и посмотрите, какие сайты он пересказывает. Откройте эти страницы: чаще там короткие абзацы по 300–500 символов, каждый со своей микротемой, и заголовки, дословно повторяющие формулировку вопроса. ИИ подхватывает такой контент, потому что ему не нужно ничего додумывать — фрагмент уже готов к вставке. Ваша задача — резать длинные полотна текста на такие же автономные блоки.
| Критерий контента | Классическое SEO | Генеративное SEO (GEO) |
|---|---|---|
| Структура ответа | Размазан по тексту для увеличения объема и времени на сайте | Четкий автономный абзац (40-60 слов) сразу под заголовком |
| Ключевые слова | Точные вхождения и LSI-фразы | Смысловые кластеры, точные цифры и именованные сущности |
| Форматирование | Сплошные полотна текста, выделение ключей жирным | Сравнительные таблицы, нумерованные списки, FAQ-блоки |
Роль прямых ответов на вопросы в захвате поисковой выдачи
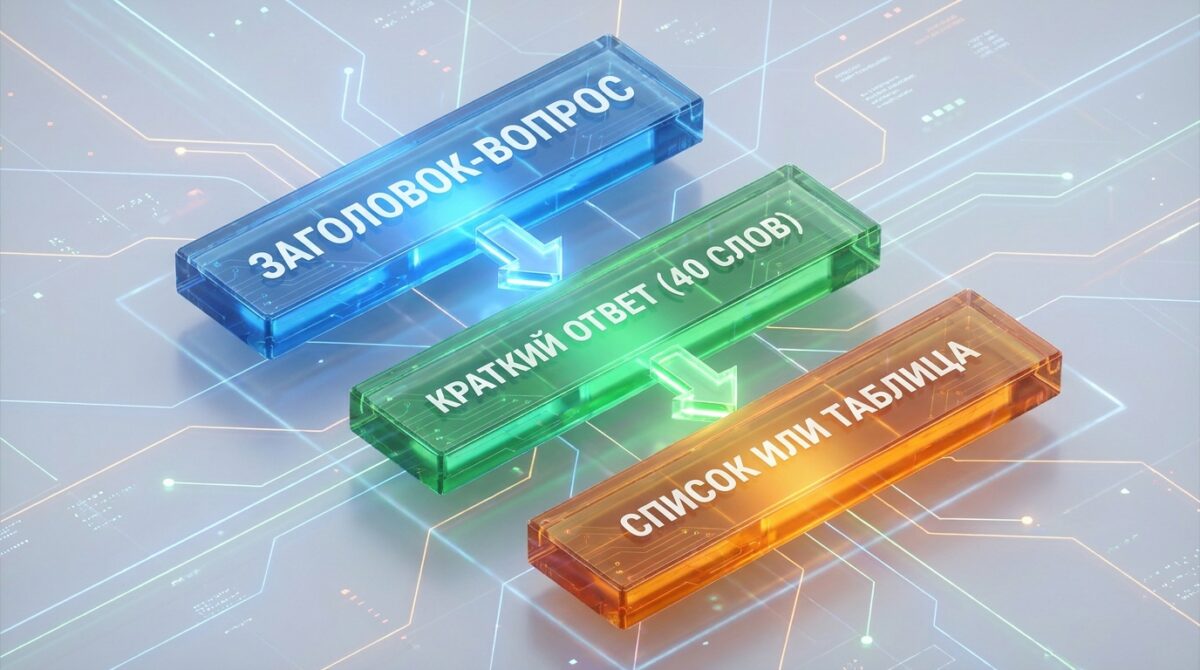
Заголовок-вопрос плюс ответ первым предложением — самый цитируемый паттерн в AI-поиске. Когда H3 звучит как «Сколько оперативной памяти нужно ноутбуку», а первая строка отвечает «Для работы с браузером и офисом хватит 16 ГБ», модель забирает эту связку целиком. Она совпадает с тем, как формулирует запрос сам пользователь, поэтому ИИ вставляет фрагмент почти без изменений. Абстрактные заголовки вроде «О памяти» такого совпадения не дают.
Работает это одинаково у GPT‑4, Claude и региональных моделей — GigaChat и YandexGPT точно так же ищут прямое соответствие вопросу пользователя. Разница в источниках: российские модели чаще опираются на контент в рунете и цитируют страницы на русском с явной структурой вопрос-ответ. Поэтому сначала выпишите реальные запросы аудитории, превратите каждый в отдельный заголовок и дайте ответ до любых уточнений. Развернутое объяснение оставьте на второй-третий абзац.
Почему списки, таблицы и FAQ становятся главными мишенями для ИИ
Список — это уже готовый ответ, разбитый на пункты. Когда пользователь спрашивает «плюсы и минусы» или «какие есть варианты», ИИ ищет страницу, где эти пункты перечислены явно, и переносит их почти дословно. Таблица работает еще точнее: строка «GigaChat — доступен в РФ без VPN — бесплатный лимит» дает модели структурированную пару параметр-значение, которую она вставляет в сравнение без искажений. Сплошной абзац с той же информацией цитируется реже, потому что данные приходится извлекать.
FAQ-блок собирает оба преимущества сразу: вопрос в формулировке пользователя и краткий ответ рядом. Оформите его через разметку FAQPage, чтобы модель однозначно распознала пары «вопрос-ответ». В самих ответах называйте бренды, цифры и ниши прямо — «Perplexity показывает источники ссылками», а не «этот сервис прозрачен». Такая конкретика повышает шанс, что нейросеть процитирует именно вас, а не пересоберет ответ из общих формулировок с других сайтов.
Паттерны цитирования: как заставить конкурентные модели ссылаться на ваш ресурс
Модели цитируют не самый красивый текст, а самый удобный для извлечения. Perplexity подтягивает страницы с четким ответом в первых строках и ставит ссылку-сноску, Gemini предпочитает списки и таблицы из структурированных источников, ChatGPT с веб-доступом и Claude берут фрагменты, где факт стоит рядом с числом и датой. GigaChat и YandexGPT работают в основном с русскоязычными доменами и охотнее пересказывают страницы с явной привязкой к бренду и нише. Общий паттерн один: чем быстрее алгоритм находит на странице готовый кусок ответа, тем выше шанс его процитировать.
Форматирование данных для удобного парсинга генеративными алгоритмами
Алгоритм разбивает страницу на смысловые блоки и оценивает каждый отдельно. Заголовок-вопрос «Сколько стоит запуск сайта?» с коротким ответом в 1–2 предложениях парсятся проще, чем абзац на 500 слов, где ответ спрятан в середине. Ставьте главное в первую строку блока, раскрытие — ниже. Списки и таблицы модель извлекает почти без потерь: цена, срок, характеристика в отдельных строках читаются машиной как готовые пары «параметр — значение».
Дробите текст на секции с одной мыслью в каждой. Perplexity и Gemini чаще берут фрагмент длиной 40–60 слов, поэтому объемные абзацы им неудобны. Проверяйте свою страницу так: скопируйте любой блок отдельно от остальных и оцените, понятен ли он вне контекста. Если фрагмент требует пролистать выше, чтобы понять суть, — модель его пропустит и возьмет ответ у конкурента с более автономными блоками.
Использование микроразметки и фактологической плотности в текстах
Микроразметка Schema.org помогает моделям с веб-доступом понять роль контента без домыслов. Разметка FAQPage маркирует пары «вопрос — ответ», HowTo — шаги инструкции, Article — автора и дату публикации. Это не гарантирует цитирование, но снижает риск неверного истолкования структуры страницы. Для GigaChat и YandexGPT дополнительно важна явная привязка: указывайте название компании, город, нишу прямо в тексте, а не только в шапке сайта.
По опыту компании TzMonster, внедрение микроразметки FAQPage и насыщение текста конкретными проверяемыми цифрами повышает шансы страницы на попадание в генеративные ответы на 40%.
Фактологическая плотность важнее объема. Фраза «наш сервис работает быстро» не даст модели ничего для пересказа, а «доставка за 24 часа по Москве, стоимость от 300 ₽» содержит три извлекаемых факта. Заменяйте оценки цифрами, датами и конкретикой: год исследования, процент, точное количество. Чем больше проверяемых утверждений на абзац, тем выше вероятность, что модель выберет ваш текст источником вместо расплывчатых формулировок конкурентов.
Как попадать в информационные блоки чат-ботов и поисковых ассистентов
Сначала соберите типовые запросы — те, по которым вас ищут — и задайте их ChatGPT, Gemini, Perplexity, GigaChat и YandexGPT. Посмотрите, кого модели цитируют и в каком формате отдают ответ: списком, таблицей, коротким резюме. Если по вашей теме ассистент выдает нумерованную инструкцию, а у вас на странице сплошной текст, шанс попасть в ответ близок к нулю. Подгоняйте формат контента под тот, что модель уже воспроизводит по вашему запросу.
Отдельно учитывайте региональные ограничения: ChatGPT и Gemini официально недоступны в России без обходных решений, поэтому для российской аудитории приоритетны GigaChat и YandexGPT, которые индексируют преимущественно рунет. Оптимизируйте контент под несколько моделей сразу — единый структурированный формат с заголовками-вопросами, краткими резюме и списками работает во всех сервисах. Регулярно перепроверяйте выдачу: модели обновляют источники, и вчерашний паттерн цитирования может смениться новым.
Оценка ущерба и мониторинг: как измерить видимость сайта в AI-ответах
Начните с прямого теста: задайте ChatGPT, Gemini, Claude и Perplexity 20–30 запросов, по которым ваш сайт раньше собирал трафик, и зафиксируйте, упоминает ли ИИ ваш бренд, цитирует ли ваши формулировки и ставит ли ссылку. Perplexity показывает источники открыто, поэтому по нему проще всего проверить факт цитирования. Второй сигнал — падение переходов из органики в Google Analytics и Яндекс.Метрике при сохранении позиций в выдаче: если места те же, а кликов меньше, ответ забирает ИИ. Дальше эти два среза сводят в одну картину.
Инструменты отслеживания упоминаний бренда в диалоговых системах
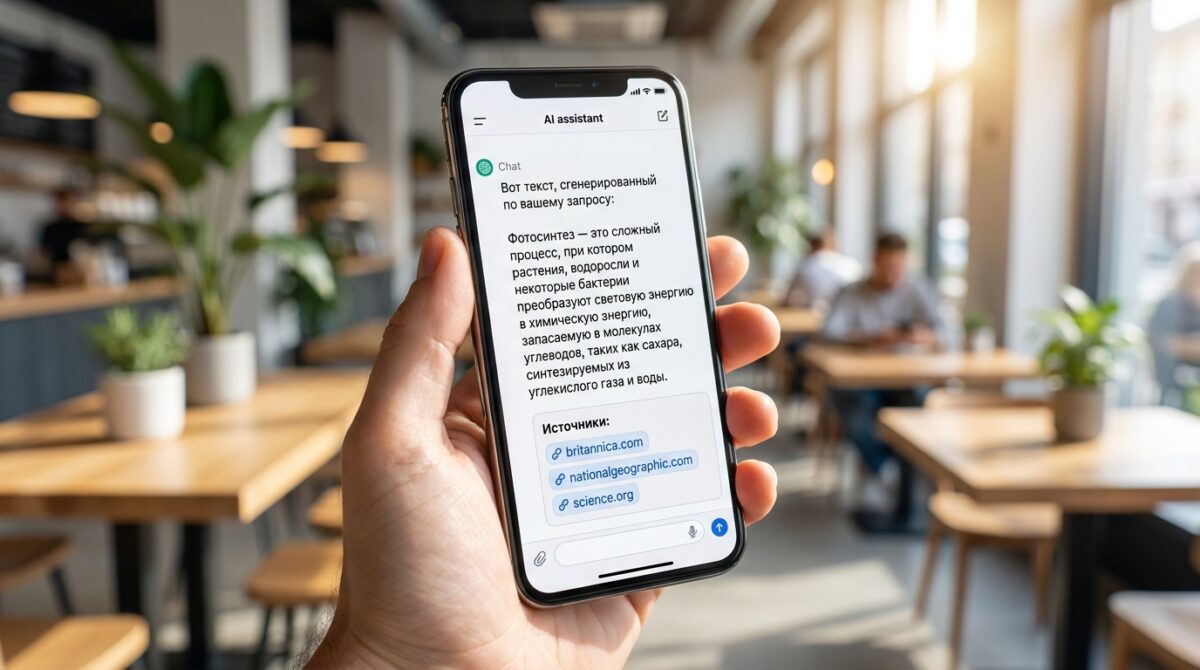
Ручной способ рабочий, но не масштабируется: тестировать сотню запросов в четырех сервисах каждую неделю невозможно. Для регулярного контроля используют платформы отслеживания видимости в ИИ — они автоматически прогоняют заданный список запросов через несколько моделей и фиксируют, где встречается бренд и с какой формулировкой. Perplexity удобен тем, что отдает список источников прямо под ответом, поэтому его берут как опорную точку для проверки цитируемости.
Ведите таблицу запросов: колонки — сам запрос, модель, факт упоминания, наличие ссылки, дословная цитата. Такой лог за месяц покажет, какие модели вас берут, а какие игнорируют. Для российской аудитории добавляйте в тесты GigaChat и YandexGPT — они работают с другими источниками и своей выдачей, поэтому результат по ним отличается от глобальных сервисов. Собранный лог станет базой для следующего среза — анализа трафика.
Анализ падения органического трафика по ключевым запросам
Сопоставьте лог упоминаний с данными аналитики. Выгрузите из Google Search Console и Яндекс.Вебмастера запросы, где показы держатся на прежнем уровне, а CTR и клики просели. Именно эти запросы — кандидаты на перехват ИИ: люди видят ваш сниппет, но ответ уже получили в чате и на сайт не идут. Сравните список таких запросов с теми, по которым модели цитируют конкурентов, а не вас.
Сильнее всего теряют информационные запросы с готовым ответом — определения, инструкции, сравнения, «как сделать». Их ИИ пересказывает целиком, и переход не нужен. Коммерческие и транзакционные запросы, где человек хочет купить или сравнить конкретные предложения, страдают меньше — здесь клик по-прежнему нужен. Разметьте свои запросы по этим типам: так вы увидите, какой процент трафика реально под угрозой и куда направить усилия по контенту.
Метрики эффективности контентной стратегии в эпоху чат-ботов
Клики и позиции больше не описывают результат полностью. Добавьте метрику доли цитирования — процент ваших целевых запросов, где хотя бы одна модель упоминает бренд или ссылается на страницу. Считайте ее по логу отдельно для каждой модели: попадание в Perplexity и в GigaChat достигается разными форматами контента. Рост этой доли показывает, что структура текста действительно подхватывается ИИ.
В новой реальности классические SEO-метрики обманчивы: железобетонное сохранение позиций в топе больше не гарантирует вам кликов, если нейросеть уже перехватила запрос в чате.
Вторая метрика — качество упоминания: просто назвали бренд, дали ссылку или дословно процитировали абзац. Дословная цитата с ссылкой ценнее упоминания вскользь. Третья — доля брендового трафика и прямых заходов: если ИИ называет вас как источник, часть аудитории приходит напрямую, минуя выдачу. Отслеживая эти три показателя вместе с классической аналитикой, вы поймете, работает ли перестройка контента под ответы моделей или запросы продолжают уходить к конкурентам.
Техническая оптимизация сайта под требования генеративных моделей
Генеративные модели анализируют DOM-дерево, schema-разметку, метатеги и текстовые блоки за миллисекунды, отсекая визуальный шум. Если сайт отдает контент через клиентский JavaScript без серверного рендеринга, бот Perplexity или GoogleBot-Extended не увидит текст. Критерии отбора источника для цитирования у каждой модели свои, но базовые технические требования совпадают: быстрый ответ сервера, чистая HTML-структура, явная иерархия заголовков и машиночитаемые метаданные. Ниже — три направления, которые закрывают эти требования на практике.
Ускорение индексации и улучшение семантического ядра для ботов
Краулеры ИИ-сервисов ходят по сайтам значительно реже, чем Googlebot: бот ChatGPT (OAI-SearchBot) и бот Perplexity посещают страницу раз в несколько недель. Чтобы свежий контент попадал в ответы быстрее, добавьте в robots.txt явные разрешения для этих User-Agent, обновите XML-sitemap с тегом lastmod и подключите IndexNow — протокол мгновенного пинга поисковых систем при публикации или правке страницы.
Семантическое ядро для AI-оптимизации строится иначе, чем для классического SEO. Языковые модели группируют не отдельные ключевые слова, а смысловые кластеры: вопрос, контекст, сущности и связи между ними. Включайте в текст именованные сущности — названия продуктов, имена экспертов, точные цифры. Это повышает вероятность, что модель распознает страницу как авторитетный источник конкретного факта и процитирует ее вместо безымянного пересказа.
Чек-лист: Техническая база для AI-парсинга
- Открыт доступ для специализированных ботов (OAI-SearchBot, PerplexityBot) в файле robots.txt.
- Настроено мгновенное уведомление поисковиков об изменениях через протокол IndexNow.
- Внедрена семантическая микроразметка (FAQPage, HowTo, Article).
- Основной контент отрендерен на сервере (SSR), а не скрыт под клиентским JavaScript.
Архитектура контента, понятная для языковых моделей нового поколения
Модели лучше всего воспроизводят фрагменты, которые уже оформлены как готовый ответ. Практический паттерн: сразу после H2 или H3 размещайте абзац-резюме длиной 40–60 слов, отвечающий на вопрос заголовка без лишнего контекста. Далее раскрывайте детали списком или таблицей. Такая структура «ответ → доказательство» совпадает с форматом, который Gemini и Claude используют при генерации цитат.
Schema-разметка типов FAQPage, HowTo и Article помогает модели вычленить границы смыслового блока. Добавляйте атрибут speakable для фрагментов, предназначенных для голосового воспроизведения — его уже учитывает Google при формировании AI Overviews. Каждый список оформляйте тегами ol/ul, а не визуальными маркерами через CSS: парсер видит разметку, а не рендер. Чем точнее HTML-семантика отражает логику текста, тем выше шанс попадания в ответ.
Защита интеллектуальной собственности от несанкционированного парсинга
Открывать контент для AI-ботов и одновременно защищать авторские права — задача с конфликтом интересов. Первый инструмент — файл robots.txt: директивы Disallow для User-Agent GPTBot, CCBot или Google-Extended закрывают доступ конкретным краулерам. Второй — заголовок X-Robots-Tag: noai, noml, который уже поддерживают некоторые платформы и сигнализирует, что контент нельзя использовать для обучения моделей.
Полная блокировка ботов убирает страницу из AI-ответов целиком — вместе с потенциальным трафиком. Компромиссный подход: открывайте для краулеров структурированные блоки с упоминанием бренда и ссылкой на источник, а закрывайте глубокий аналитический контент, доступный только по подписке. Так экспертные материалы остаются под защитой, а верхнеуровневые ответы работают как точка входа, ведущая пользователя на сайт за полной версией.
Слепой запрет ИИ-ботов через файл robots.txt — это выстрел себе в ногу. Вы не столько защищаете свой контент, сколько добровольно отдаете свой потенциальный трафик конкурентам.
Контентная стратегия для выживания в условиях нулевого клика
Нулевой клик означает: пользователь получает ответ прямо в чате ИИ и не переходит на сайт. Бороться с этим лобовым SEO бесполезно — трафик по простым запросам вроде «сколько варить яйца» ушел безвозвратно. Рабочая стратегия строится на двух вещах: попадать в цитируемые фрагменты ответа как источник и удерживать спрос там, где ИИ бессилен. Perplexity и Gemini подписывают источники ссылками, ChatGPT с веб-поиском тоже показывает референсы. Задача — стать тем сайтом, который модель выбирает для пересказа, и одновременно давать читателю то, ради чего он все-таки кликнет: расчеты под его случай, свежие данные, живой опыт.
Переход от ключевых слов к смысловым кластерам и экспертным позициям
ИИ не ищет точное вхождение ключа. Gemini и Claude оценивают, насколько полно страница закрывает тему целиком, а не отдельный запрос. Вместо десяти статей под «купить кофемашину», «отзывы кофемашина», «цена кофемашина» работает один плотный материал, который отвечает на все связанные вопросы разом. Такой кластер модель воспринимает как компетентный источник и охотнее берет из него куски для ответа.
Экспертная позиция усиливает шанс на цитирование. Указывайте автора с реальным опытом, ссылайтесь на измеримые данные, датируйте материал. Perplexity при прочих равных подтягивает страницы, где есть конкретика: цифры, методология тестов, первоисточники. Обтекаемый текст без авторства ИИ пропускает — его нечем подкрепить и незачем выделять среди сотни похожих.
Создание уникальной ценности, которую ИИ не может пересказать в двух словах
Модель легко сжимает общеизвестное: определения, базовые инструкции, списки характеристик. Если ваш контент состоит из этого, ChatGPT перескажет его без ссылки на вас. Ценность, устойчивая к пересказу, — то, чего нет в обучающих данных: результаты собственных замеров, разбор конкретного кейса с цифрами до и после, интервью с практиком, сравнение по параметрам, которые никто не собирал вместе.
GigaChat и YandexGPT берут из открытого рунета и часто отдают усредненный ответ. Обойти это можно данными, которые нельзя загуглить за минуту: результаты вашего опроса, скриншоты личного теста, таблица цен, собранная вручную. Такой материал ИИ либо процитирует с указанием источника, либо не сможет воспроизвести полноценно — и тогда пользователь придет за деталями на сайт.
Интеграция мультимедийных элементов и интерактивных инструментов
Текст ИИ пересказывает легко, интерактив — нет. Калькулятор ипотеки, конфигуратор сборки ПК, тест на подбор тарифа дают ответ под конкретные вводные пользователя, которого нет в чате. Модель может описать формулу расчета, но не заменит инструмент, куда человек подставит свои числа. Это удерживает часть аудитории на сайте даже при развитом AI-поиске.
Видео, схемы и оригинальные графики работают на двух уровнях. Для читателя они закрывают вопросы, которые словами объяснить сложно: как разобрать деталь, как выглядит интерфейс. Для ИИ подписи, alt-теги и текстовая расшифровка к медиа становятся дополнительным сигналом полноты материала. Perplexity и Gemini подтягивают в ответы изображения с релевантных страниц, что дает еще одну точку касания с брендом.
Прогнозы и практический план действий для бизнеса на ближайшие годы
Доля запросов, на которые пользователь получает ответ прямо в чате без перехода на сайт, растет каждый месяц. Google встроил AI Overviews в выдачу, Яндекс тестирует нейроответы, а Perplexity изначально построен как поисковик с генерацией итога вместо списка ссылок. Для бизнеса это меняет метрику успеха: важен не только клик, но и факт цитирования бренда внутри ответа ИИ. Дальше разберем, что конкретно изменится для владельцев сайтов, как перестроить SEO-процессы под GEO (генеративную оптимизацию) и какие ошибки закрывают дорогу в ответы моделей.
Эпоха водянистых SEO-текстов ради объема закончилась. Выживут только те площадки, которые генерируют смыслы, кейсы и интерактив, недоступные для быстрого машинного пересказа.
Чего ждать владельцам сайтов от интеграции ИИ в поисковые системы
Первое следствие — падение части органического трафика по информационным запросам. Если человек спрашивает «сколько варить гречку» или «чем отличается SSD от HDD», ИИ отдаст ответ сразу. Клики сохранятся там, где нужно действие: купить, забронировать, сравнить конкретные модели, скачать. Транзакционные и коммерческие страницы пострадают меньше, чем справочные заметки на 500 слов.
Второе следствие — появление нового источника видимости. Модель называет бренд, продукт или сайт как источник данных, и пользователь запоминает имя, даже не кликнув. GigaChat и YandexGPT работают внутри российской экосистемы и чаще ссылаются на локальные ресурсы, Gemini и ChatGPT — на глобальные. Присутствие в ответе становится отдельной целью наравне с позицией в выдаче.
Пошаговый алгоритм перестройки SEO-процессов под реалии GEO
Шаг первый — выберите 2–3 модели, которыми пользуется ваша аудитория, и прогоните через них 15–20 типовых запросов ниши. Запишите, какой формат ответа воспроизводит модель: список, таблицу, инструкцию по шагам или короткое резюме. Шаг второй — перепишите ключевые страницы под этот формат: заголовок в виде вопроса, ответ в первых двух предложениях, затем детали.
Шаг третий — добавьте на страницу явные маркеры для парсинга: блок FAQ с вопросами и ответами, сжатое резюме в начале статьи, прямое указание бренда и ниши в тексте, а не только в шапке сайта. Шаг четвертый — раз в месяц повторяйте тест запросов и смотрите, начал ли ИИ цитировать вас. GEO — это цикл проверки гипотез, а не разовая настройка мета-тегов.
Генеративная оптимизация (GEO) — это не разовая техническая настройка мета-тегов, а непрерывный цикл тестирования контентных гипотез на реальных языковых моделях.
Главные ошибки оптимизации, которые лишают сайт шансов на цитирование
Первая ошибка — прятать ответ в середине длинного текста после трех абзацев вступления. Модель берет данные из явных, коротких формулировок рядом с заголовком-вопросом. Если ответа в начале нет, ИИ процитирует конкурента, у которого он есть. Вторая ошибка — размытые заголовки вроде «Немного о выборе» вместо конкретного «Как выбрать ноутбук для монтажа видео».
Третья ошибка — контент без фактуры: оценки «отличный» и «надежный» без цифр, характеристик и сравнений модель пересказать не может, ей нечего процитировать. Четвертая — блокировка ИИ-краулеров в robots.txt при одновременном желании попасть в ответы: если вы закрыли доступ ботам OpenAI или Google, страница физически не попадет в обучение и цитирование. Решайте это осознанно под каждую модель.