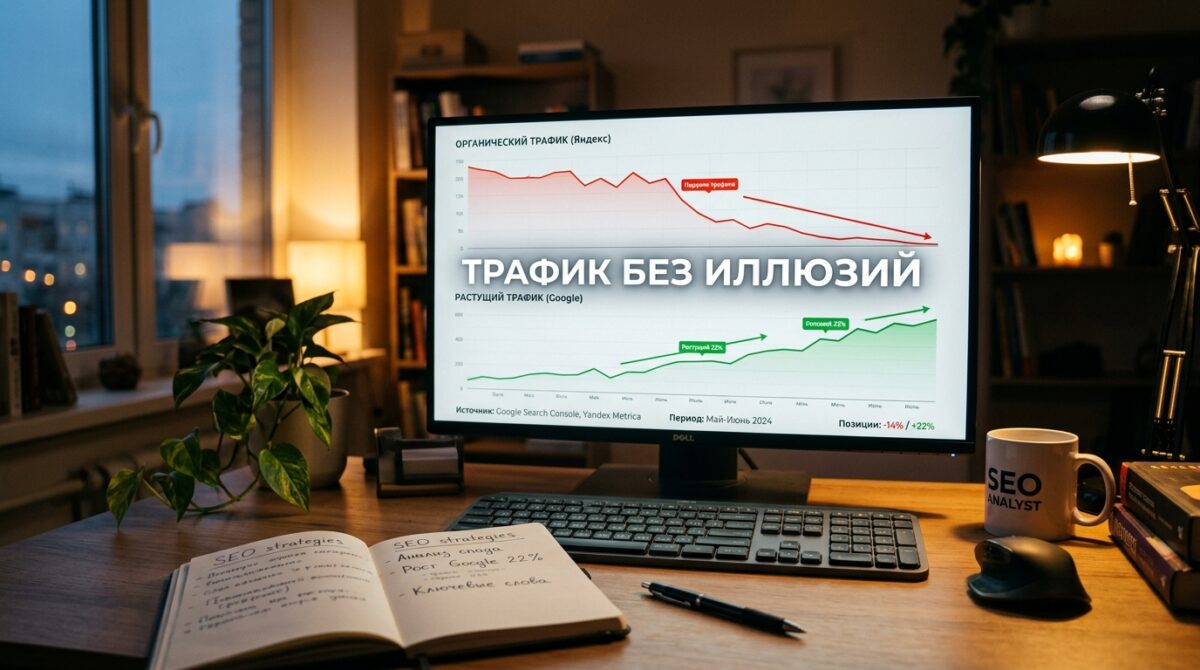
Цифры трафика конкурентов в Similarweb, Serpstat и PR-CY — это оценка, не факт. Реальную статистику видит только владелец сайта. Сервисы дают ориентир с погрешностью, иногда в разы. Копировать чужие показатели вслепую — прямой путь слить бюджет. Стабильный трафик не настраивают один раз: он держится на анализе своих данных, доработке SEO-структуры и постоянном мониторинге. Разберем, где врут внешние инструменты, чем внутренняя аналитика отличается от анализа конкурентов и как превратить статистику сайтов в рабочий инструмент роста.
- Данные Similarweb, Serpstat и PR-CY — это оценки с погрешностью в разы, не факты. Реальную статистику видит только владелец сайта через GA4 и Яндекс Метрику. Внешние сервисы собирают информацию из косвенных источников (браузерные расширения, клик-стрим), а не из счетчиков конкурентов.
- Чужие данные используют как гипотезы для поиска упущенных ключевых слов и каналов привлечения, а свою аналитику — как проверку результатов. Абсолютные числа конкурентов вторичны; ценна структура распределения трафика по источникам и семантика запросов.
- Падение трафика вызывают дефекты архитектуры (дубли, битые редиректы, плохая структура), несоответствие контента интенту пользователя (высокий отказ, низкое время на странице) или объективные факторы (сезонность, апдейты алгоритмов).
- Стабильный трафик достигается через постоянный аудит своих страниц, перестройку контента под реальный спрос, кластеризацию семантики и еженедельный мониторинг позиций и поведенческих метрик, а не разовой настройкой.
Иллюзия точных цифр: почему внешние инструменты дают лишь общую картину
Similarweb, Serpstat, SpyWords и PR-CY не подключены к счетчикам чужих сайтов — у них нет доступа к GA4 или Метрике конкурентов. Цифры они собирают из косвенных источников: данных браузерных расширений, панелей пользователей, кликстрим-провайдеров и своих баз ключевых слов. Потом эти обрывки экстраполируют на весь рунет через математические модели. Отсюда и погрешность: у крупных сайтов оценка ближе к правде, у мелких — расходится с реальностью в разы, а иногда сервис показывает трафик там, где его почти нет. Воспринимайте эти числа как порядок величины и вектор, но не как факт для расчета своей стратегии.
Что скрывают счетчики и почему данные аналитических платформ отличаются от реальности
Счетчик на вашем сайте фиксирует каждый визит: источник, устройство, путь по страницам, время на сайте, конверсию. Внешний сервис этого не видит и достраивает картину по выборке. Если в панели провайдера мало пользователей из вашей ниши, оценка проседает; если сайт молодой или региональный, его могут вовсе не заметить. Поэтому две платформы часто показывают разный трафик по одному домену — каждая считает по своей модели.
Разница между публичными сервисами и реальными счетчиками колоссальна. Специалисты TzMonster отмечают, что планирование бюджета на основе данных Similarweb для узких ниш часто приводит к фатальным ошибкам в прогнозах, где погрешность достигает 300%.
Различаются и методики подсчета: одни сервисы отдают визиты, другие — уникальных пользователей или просмотры, третьи фильтруют ботов иначе. Отдельная проблема — обновление баз: часть платформ пересчитывает данные раз в месяц, и вы видите картину с задержкой. Сравнивать домены между собой внутри одного сервиса можно — относительная разница сохраняется. А вот брать абсолютное число и планировать по нему выручку — ошибка.
Внутренняя веб-аналитика против публичной конкурентной разведки
У этих инструментов разные задачи. GA4 и Яндекс Метрика — это точные данные о вашем сайте: реальные источники переходов, поведение по сегментам, воронки, доходимость до цели и конверсии. На этих цифрах строят решения, потому что они основаны на фактических событиях, а не на модели. Ошибка здесь возможна из-за неправильной настройки целей или фильтрации спама, но сами визиты — настоящие.
Публичная разведка через Similarweb или SpyWords отвечает на другой вопрос: по каким запросам конкурент собирает трафик, какие страницы у него в топе, где он покупает рекламу и как распределяет источники. Абсолютные числа тут вторичны — ценна структура. Вы видите ниши спроса, которые упустили, и форматы страниц, которые работают. Правильная связка: своими данными измеряете результат, чужими — ищете точки роста и гипотезы для проверки.
| Параметр | Внешние сервисы (Similarweb, Serpstat) | Внутренняя аналитика (GA4, Метрика) |
|---|---|---|
| Точность данных | Ориентировочная (математическая модель) | Абсолютная (фиксация фактов счетчиком) |
| Главная ценность | Поиск гипотез и структуры спроса ниши | Измерение реальных бизнес-результатов |
| Риски использования | Погрешность на малых сайтах до 300% | Ошибки в настройке целей и спам-трафик |
🚀 Тексты, которые нравятся поисковикам
ТЗМонстр — умный нейропомощник для SEO и блогов. Автоматически собирает LSI-фразы, генерирует детальное ТЗ и пишет экспертные статьи лучше обычного ChatGPT. От 15₽ за готовый план работы.
Как правильно использовать чужую статистику для своей стратегии
Оценки сервисов работают как ориентир, а не как цель для копирования. Similarweb показывает распределение источников трафика конкурента, Serpstat и SpyWords — по каким запросам он попадает в выдачу, PR-CY — технические параметры и приблизительную посещаемость. Эти данные отвечают на два вопроса: откуда конкурент берет людей и на каких темах зарабатывает. Дальше вы сверяете это со своим сайтом через GA4 и Метрику, где цифры уже точные. Логика простая: чужие сервисы дают гипотезы, ваша аналитика — проверку. Ниже разберем три задачи, которые решает такой подход.
Ищем лидеров ниши и изучаем их каналы привлечения пользователей
Соберите 5–7 сайтов из топа выдачи по вашим основным запросам и прогоните их через Similarweb. Сервис разложит трафик по каналам: поиск, прямые заходы, реферальные ссылки, соцсети, реклама. Если у лидера 70% приходит из органики, а у вас — 20%, вы видите канал с недобором. Это не приговор, а точка приложения усилий.
Дальше смотрите, откуда идут реферальные переходы конкурента: часто это отраслевые каталоги, форумы, статьи на профильных площадках. Такие источники повторяемы — вы можете зайти на те же площадки. Но помните про погрешность: если сервис показывает конкуренту 100 тысяч визитов, реальная цифра может быть и 60, и 150 тысяч. Используйте пропорции между каналами, а не абсолютные значения.
Находим упущенные ключевые слова и темы через чужой опыт
Serpstat и SpyWords показывают семантику конкурента — список запросов, по которым его сайт виден в выдаче. Выгрузите эти запросы и сравните со своим ядром через функцию пересечения доменов. На выходе получите ключи, по которым ранжируется конкурент, а вы нет. Это готовый список тем для новых страниц и статей, подкрепленный спросом, а не предположением.
Отбирайте не все подряд, а запросы с реальной частотностью и понятной интентом под вашу нишу. Проверяйте частоту через Wordstat или планировщик, отсекайте нерелевантное. Один конкурент дает срез, десять — карту спроса ниши. По этой карте вы дорабатываете структуру сайта: закрываете пробелы в темах и перераспределяете контент под запросы, которые приносят конкуренту трафик.
Цена ошибки: почему слепое копирование чужих показателей ведет к сливу бюджета
Погрешность сервисов на малых сайтах доходит до нескольких раз, а на новых доменах данных вообще может не быть. Если вы поверите завышенной оценке трафика конкурента и решите, что тема принесет 50 тысяч визитов, а по факту там 8 тысяч, вы вложите деньги в контент, который не окупится. Сервис оценивает, вы платите за реальность.
Слепое копирование действий конкурентов — это покупка билета на поезд, который уже ушел. Вы видите долю канала, но не знаете его рентабельность и цену привлечения каждого лида.
Вторая ловушка — копирование каналов без учета контекста. Конкурент мог купить дорогую рекламу или получить всплеск от вирусной публикации, которую не повторить. Similarweb покажет долю канала, но не расскажет, во сколько он обошелся и остался ли рабочим. Проверяйте гипотезы на малых бюджетах, сверяйте результат с GA4 и масштабируйте только то, что дало отдачу на вашем сайте.
Анатомия падений: как сломанная SEO-структура убивает стабильный трафик
Провалы трафика редко случаются на ровном месте — у них есть причины, видные в данных. Часть причин внутри сайта: битая архитектура, дубли страниц, тексты мимо запроса пользователя. Часть — снаружи: сезонный спрос и апдейты алгоритмов, на которые владелец не влияет напрямую. Смешивать эти два типа причин нельзя. Если списать падение из-за технической ошибки на «очередной апдейт Google», проблему не почините. Дальше разберем три группы факторов: дефекты структуры, поведенческие сигналы и объективные ограничения — и покажем, как каждый из них читать по статистике своего сайта.
Как дефекты архитектуры сайта мешают роботам сканировать контент
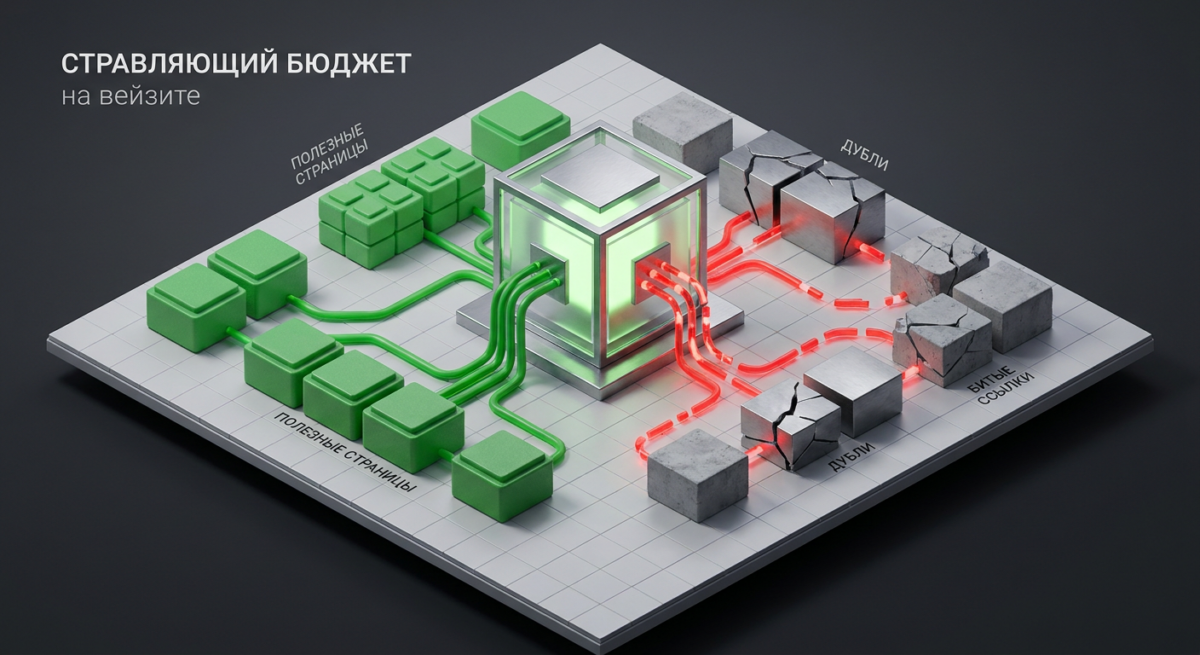
Робот тратит на сайт ограниченный краулинговый бюджет. Если бюджет уходит на дубли, страницы фильтров с параметрами и бесконечные редиректы, важные разделы сканируются реже или выпадают из индекса. Признаки в отчетах Search Console: страницы «Обнаружены, не проиндексированы», рост исключенных URL, скачки времени ответа сервера. Каждый такой дефект — это страницы, которые просто не участвуют в выдаче.
Плоская или запутанная структура добавляет проблем. Если до важной статьи от главной три-четыре клика, вес распределяется тонким слоем, и раздел проседает. Лечится перелинковкой, чисткой дублей через canonical, настройкой robots.txt и sitemap. После доработки структуры сравнивают глубину индексации до и после — это показывает, вернулись ли страницы в работу и подрос ли трафик на них.
Поведенческие факторы как главный индикатор того, что текст не попал в интент
Страница в индексе, позиции есть, а трафика нет — смотрите на поведение. Высокий процент отказов, короткое время на странице и быстрый возврат в выдачу говорят одно: контент не отвечает на запрос. Пользователь искал инструкцию, а получил рекламный текст — и ушел к конкуренту. Поисковик считывает этот сигнал и постепенно опускает страницу. В GA4 и Метрике это видно по глубине просмотра и вовлеченности по конкретным посадочным URL.
Чтобы совместить контент с интентом, разбирают саму выдачу по запросу: какой формат в топе — подборка, калькулятор, пошаговое руководство. Затем переписывают страницу под этот формат, добавляют ответ в первый экран и убирают воду. После правок отслеживают динамику отказов и время на странице по когортам — если поведение улучшается, позиции и трафик подтягиваются следом.
Сезонность, апдейты алгоритмов и другие объективные ограничения
Часть колебаний не зависит от качества сайта. Спрос на шины, отопление или подготовку к экзаменам растет и падает по календарю — это сезонность, и ее видно, если наложить трафик на данные Google Trends и Вордстата за пару лет. Провал в межсезонье — норма, а не поломка. Планировать бюджет и контент проще, когда график спроса известен заранее: тексты готовят к пику, а не в момент спада.
- Проверка сезонности: Сравнение текущих графиков с историей спроса в Google Trends и Вордстате за последние 2-3 года.
- Технический аудит: Поиск новых дублей, ошибок 404 и скачков времени ответа сервера в отчетах Search Console.
- Анализ интента: Выявление посадочных страниц с резким ростом показателя отказов и падением времени просмотра.
- Сверка с апдейтами: Мониторинг официальных радаров поисковых систем на предмет глобального изменения алгоритмов ранжирования.
Апдейты поисковиков — вторая объективная сила. Core update способен перетасовать выдачу за неделю, и позиции проседают даже у технически исправного сайта. Отличить апдейт от своей ошибки помогает совпадение даты падения с анонсами Google и Яндекса и массовость — если просел весь сегмент запросов сразу. В таком случае реакция одна: не паниковать, дождаться стабилизации алгоритма и усиливать экспертность контента, а не откатывать правки наугад.
Пошаговая оптимизация: превращаем текущие данные в инструмент роста
Работа начинается не с конкурентов, а со своих цифр в GA4 и Яндекс Метрике. Открывайте отчеты по источникам, посадочным страницам и конверсиям — там видно, какие разделы приводят людей и где они уходят. Дальше подключайте данные конкурентов из Serpstat или SpyWords как ориентир: смотрите, по каким запросам ранжируются чужие сайты, чтобы найти пропущенные темы. Алгоритм один: аудит текущих страниц, пересборка контента под спрос, отслеживание метрик после каждой правки. Ниже разберем каждый шаг — от поиска мест утечки аудитории до адаптации сайта под апдейты поисковиков.
Аудит существующих страниц: где мы теряем целевую аудиторию
Начните с отчета по посадочным страницам в Метрике: сортируйте по показателю отказов и глубине просмотра. Страницы с отказами выше 60% и временем менее 15 секунд не отвечают на запрос — заголовок обещает одно, а контент дает другое. Сверьте поисковый запрос из Search Console с тем, что реально написано на странице. Расхождение — причина ухода.
Второй сигнал утечки — воронка. Постройте путь от входа до целевого действия и найдите шаг с максимальным отвалом. Если люди доходят до формы заявки, но не отправляют, проблема в форме или предложении, а не в трафике. Так вы отделяете страницы, которым нужен новый контент, от тех, где мешает техника или юзабилити.
Высокий процент отказов — это крик пользователя о том, что заголовок обманул его ожидания. Поисковые системы слышат этот сигнал быстрее, чем вы успеете обновить метатеги страницы.
Перебираем контент и внедряем кластерную структуру под реальный спрос
Соберите семантику через Serpstat или Wordstat и сгруппируйте запросы по смыслу, а не по частотности. Один кластер — одна потребность пользователя. Например, «как выбрать» и «сравнение моделей» — разные интенты, им нужны отдельные страницы. Проверьте, не конкурируют ли ваши тексты за один запрос: каннибализация роняет обе страницы в выдаче.
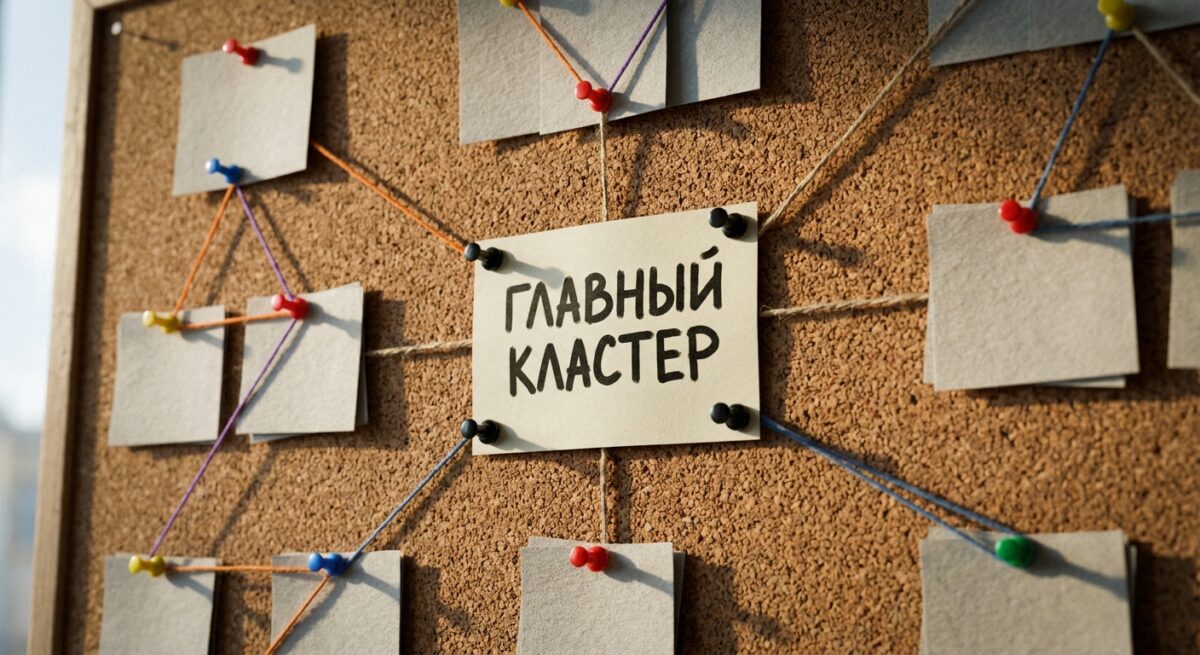
Постройте структуру по принципу «пиллар — кластеры«: главная страница раскрывает тему широко, дочерние отвечают на узкие запросы и ссылаются на пиллар. Такая связка распределяет вес по сайту и помогает поисковику понять экспертность раздела. Контент, который не собирает трафик полгода и не имеет спроса в Wordstat, объединяйте с соседним или удаляйте — разбавленная структура тянет весь сайт вниз.
Постоянный мониторинг метрик и гибкая адаптация под правила поисковиков
Стабильный трафик — результат регулярных замеров, а не разовой настройки. Раз в неделю сверяйте позиции по ключевым запросам, динамику кликов в Search Console и поведенческие метрики в Метрике. Резкое падение на 20–30% без сезонной причины — сигнал апдейта алгоритма или технической ошибки. Отмечайте даты правок, чтобы связывать изменения трафика с конкретными действиями.
Поисковики меняют алгоритмы несколько раз в год, и то, что работало вчера, завтра теряет вес. Следите за официальными анонсами Google и Яндекса, реакцию сайта проверяйте по своим данным, а не по чужим оценкам из Similarweb. Сезонные провалы сглаживают заранее: если спрос падает летом, к этому периоду готовят материалы под смежные запросы, которые держат посещаемость, пока основная тема остывает.