Вы скопировали статью из интернета на свой сайт — и через месяц получили претензию от правообладателя или упали в поиске. Любой оригинальный текст защищен авторским правом с момента создания, даже без копирайта и имени автора. «Статьи без авторских прав» — миф: таких материалов почти нет, а копирование грозит судебными исками и фильтрами Google. Легальные источники существуют: тексты в общественном достоянии, материалы под лицензиями Creative Commons, покупка прав у авторов. Расскажем, где брать контент без юридических рисков, как сделать заготовки уникальными SEO-статьями и выстроить техническую структуру для стабильного органического трафика.
- Любой текст защищен авторским правом автоматически с момента создания (минимум 70 лет); копирование грозит судебными исками до 5 млн рублей и исключением из индекса Google и Яндекса
- Поисковики определяют первоисточник по временным меткам и фильтруют дублированный контент: дубли теряют 40–90 позиций, уникальность ниже 80% = исключение из топ-10
- Легальные источники: произведения в public domain (Internet Archive, Project Gutenberg), лицензии Creative Commons (с указанием автора), покупка прав через договор с передачей имущественных прав
- Техническая оптимизация: правильная иерархия заголовков H1–H3, title 50–70 символов с ключом в начале, 2–4 внутренние ссылки на смежные статьи, квартальный аудит позиций и обновление контента для удержания рейтинга
Юридическая реальность: почему миф о «статьях без авторских прав» опасен для вашего бизнеса
В России, США, ЕС и большинстве стран действует Бернская конвенция: авторское право возникает автоматически в момент создания произведения и действует минимум 70 лет после смерти автора. Это значит, что любая статья, пост в блоге или описание товара защищены законом по умолчанию — даже если на странице нет знака © или упоминания автора. Поисковые системы определяют первоисточник по индексации и временным меткам, а правообладатели массово подают жалобы через DMCA и Яндекс.Вебмастер. Копирование чужих текстов без разрешения ведет к судебным искам с компенсацией до 5 млн рублей за один материал и к полному исключению сайта из индекса.
Как работает презумпция авторского права и автоматическая защита текстов
Согласно статье 1259 ГК РФ, авторское право распространяется на любые оригинальные произведения в литературной форме. Регистрация не требуется: текст защищен с момента фиксации на носителе — в файле Word, CMS сайта или рукописном блокноте. Отсутствие имени автора или копирайта не отменяет защиту, а только затрудняет идентификацию правообладателя.
Любая строчка текста в сети по умолчанию защищена законом с момента написания. Отсутствие знака копирайта не делает чужой контент бесплатным достоянием, а создает прямую угрозу внезапных судебных исков.
Поисковые системы фиксируют дату первой индексации через протоколы sitemap.xml и HTTP-заголовки Last-Modified. Google сохраняет временные метки в кэше, Яндекс — в базе оригинальных текстов. Если вы опубликовали чужой материал позже первоисточника, алгоритмы автоматически определят ваш сайт как вторичный. Доказать обратное в суде без письменного договора о передаче прав практически невозможно.
Чем опасен бездумный парсинг и воровство чужих материалов для SEO
Google Panda и Яндекс Королев снижают рейтинг сайтов с дублированным контентом на 40–90 позиций. Алгоритмы сравнивают шинглы — последовательности из 10 слов — и вычисляют процент совпадений. При уникальности ниже 80% страница получает метку «неоригинальный контент» и теряет право на показы в топ-10. Массовый парсинг приводит к фильтру «Переоптимизация» или полному исключению домена из индекса.
Правообладатели мониторят копии через сервисы Copyscape, Advego Plagiatus и встроенные инструменты Яндекс.Вебмастера. Одна жалоба по DMCA блокирует страницу в Google за 48 часов, массовые претензии — весь домен. В России судебная практика показывает компенсации от 10 тысяч до 5 млн рублей за статью, плюс возмещение судебных расходов. Для интернет-магазинов потеря позиций означает падение выручки на 60–80% за квартал.
| Критерий оценки | Парсинг и копипаст | Легальные источники (PD, CC, заказ) |
|---|---|---|
| Юридические риски | Иски до 5 млн руб. и блокировка по DMCA | Полная чистота при соблюдении лицензии/договора |
| Санкции поисковиков | Пессимизация на 40–90 позиций, бан в Google | Стабильная индексация и рост авторитетности |
| Трудозатраты на старт | Минимальные (быстрый парсинг) | Требуется адаптация, редактура и атрибуция |
| Долгосрочная окупаемость | Нулевая (гарантированная потеря домена) | Формирование постоянного органического трафика |
Рейд поисковиков: за что банят и пессимизируют сайты с неуникальным контентом
Яндекс применяет фильтр «Минусинск» к сайтам с автоматически сгенерированными текстами и массовыми копиями: домен исчезает из топ-100 по всем запросам на срок от 6 месяцев. Google Penguin штрафует за спам-контент и переспам ключевых слов: страницы с плотностью ключей выше 3% и точными вхождениями в каждом абзаце получают ранг «низкого качества». Manual Action от модераторов Google снимается только после ручной проверки и удаления всех нарушений.
Алгоритм E-E-A-T (Experience, Expertise, Authoritativeness, Trustworthiness) понижает сайты без указания авторства, экспертизы и источников данных. Статьи без ссылок на первоисточники, исследования и примеры расцениваются как низкокачественные. Для коммерческих тематик (финансы, медицина, юриспруденция) Google требует биографии авторов и подтверждение квалификации. Сайты, ворующие контент, не могут предоставить эти данные и автоматически попадают в категорию YMYL с жесткими ограничениями на ранжирование.
🚀 Тексты, которые нравятся поисковикам
ТЗМонстр — умный нейропомощник для SEO и блогов. Автоматически собирает LSI-фразы, генерирует детальное ТЗ и пишет экспертные статьи лучше обычного ChatGPT. От 15₽ за готовый план работы.
Легальные альтернативы: где брать материалы без жестких ограничений
Есть три проверенных источника контента, которые не приведут к судебным искам: произведения в общественном достоянии (public domain), материалы под открытыми лицензиями Creative Commons и тексты с официально переданными правами. В первом случае срок охраны истек или автор явно отказался от прав, во втором — правообладатель сам разрешил использование на определенных условиях, в третьем — вы заключаете договор и получаете эксклюзивные права. Каждый вариант требует проверки лицензии и соблюдения указанных ограничений, но дает юридическую чистоту и защиту от претензий.
Как правильно работать с контентом из Public Domain и общественного достояния
В общественном достоянии находятся произведения, срок охраны которых истек (в России — 70 лет после смерти автора), тексты госорганов и материалы, явно помеченные как CC0 или Public Domain Mark. Проверить статус можно на архивных платформах Project Gutenberg, Internet Archive, Wikimedia Commons и в национальных библиотечных каталогах.
Такой текст можно скопировать без согласия, но для SEO его придется адаптировать: добавить актуальные примеры, структурировать под ключевые запросы, дописать введение и выводы. Простое копирование старой книги не даст ранжирования, поскольку поисковики оценивают релевантность и пользу для современного читателя, а не только уникальность по антиплагиату.
Используем лицензии Creative Commons для безопасного заимствования
Creative Commons предлагает шесть типов лицензий: от CC BY (можно использовать с указанием автора) до CC BY-NC-ND (только некоммерческое использование без изменений). Проверяйте иконку лицензии в футере сайта или в карточке материала — там указаны конкретные условия. Платформы Medium, Flickr, YouTube позволяют фильтровать контент по типу CC-лицензии через расширенный поиск.
Специалисты TzMonster отмечают, что использование открытых лицензий Creative Commons безопасно лишь при неукоснительном соблюдении атрибуции: отсутствие ссылки на автора юридически приравнивается к обычному плагиату.
Чтобы не нарушить условия, укажите имя автора и ссылку на оригинал, сохраните тип лицензии в своей публикации и не используйте материал коммерчески, если стоит маркер NC. Для SEO-задач подходят лицензии CC BY и CC BY-SA: их можно редактировать, дополнять ключевыми словами и встраивать в структуру сайта при соблюдении атрибуции.
Покупаем контент по правилам: официальная передача имущественных прав
При заказе текстов на биржах (Advego, Etxt) или у фрилансеров заключайте договор с пунктом о полной передаче имущественных прав или отчуждении исключительного права. Без этого пункта автор сохраняет права, и формально вы получаете только разовую лицензию на публикацию. Шаблон договора можно взять в свободном доступе и адаптировать под свои задачи, указав стоимость, срок передачи прав и объем работ.
После оплаты и подписания акта приема-передачи текст становится вашей собственностью: вы можете редактировать, публиковать под своим брендом и защищать от копирования третьими лицами. Этот способ дороже копипаста, но исключает риск претензий и дает полный контроль над контентом, что критично для коммерческих проектов и долгосрочных SEO-стратегий.
Техническая оптимизация: превращаем сырые заготовки в ранжируемые статьи
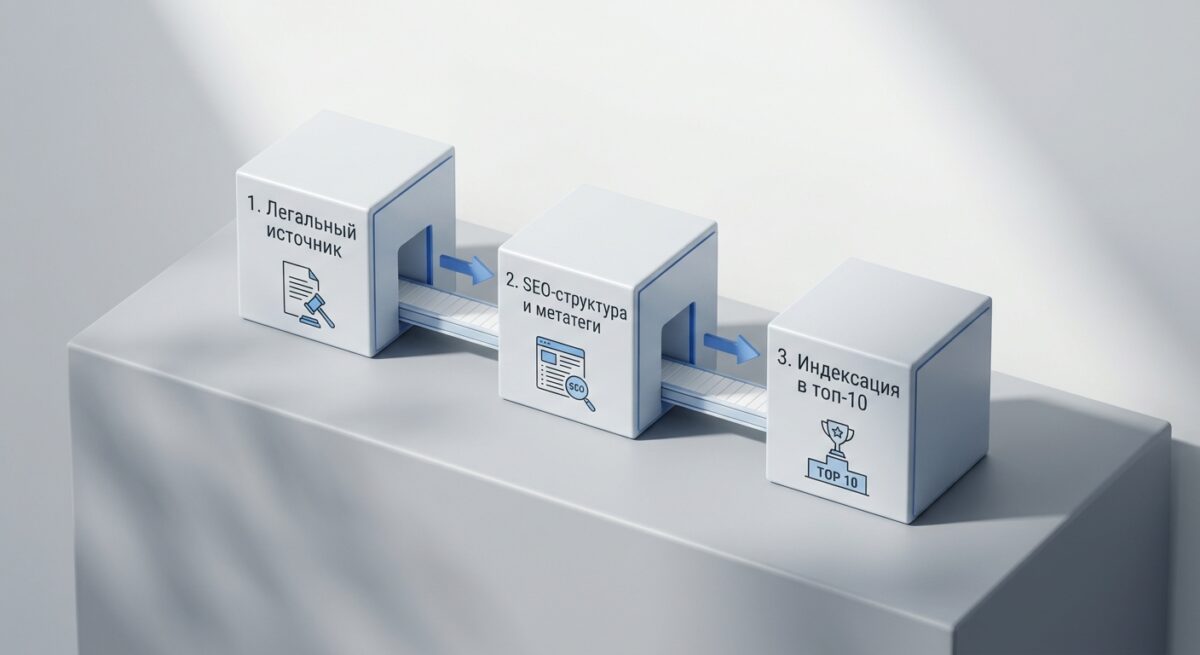
Допустим, вы нашли легальный источник — архив текстов в общественном достоянии или купили права на пакет статей. Теперь главная задача: адаптировать материал под требования поисковых систем и пользователей. Google и Яндекс оценивают не только уникальность текста, но и техническую структуру страницы: иерархию заголовков, метатеги, внутреннюю перелинковку и скорость загрузки. Статья без title, description и h1 потеряется в выдаче даже при 100% оригинальности. Разберем три ключевых блока технической оптимизации, которые превращают сырую заготовку в ранжируемый контент.
Строим SEO-структуру с правильными тегами и иерархией
Заголовок H1 должен содержать главный ключевой запрос и стоять на странице один раз. Подзаголовки H2 делят текст на смысловые блоки по подтемам запроса, H3 раскрывают детали внутри каждого блока. Нельзя пропускать уровни: после H2 сразу H4 — ошибка, которую поисковик воспринимает как нарушение логики документа. Проверяйте иерархию через валидатор HTML или плагины вроде Screaming Frog.
Каждый заголовок пишите для читателя, а не для робота: вместо «Ключевые слова здесь» используйте конкретику — «Как выбрать длину анкора для внутренних ссылок». В первых 100 словах под H1 разместите точное вхождение целевого запроса и синонимы. Это усиливает релевантность и удерживает пользователя, который сразу видит ответ на его вопрос.
- Проверка H1: ровно один заголовок первого уровня с главным запросом в начале строки.
- Сниппет Title: длина 50–70 знаков с активным триггером и отсутствием переспама.
- Смысловой Description: до 150 знаков с емким УТП и четким призывом к действию.
- Внутренние анкоры: 2–4 контекстные ссылки на релевантные посадочные страницы блога.
- Логика H2–H3: отсутствие пропусков уровней заголовков и дробление полотна каждые 300 слов.
Закрываем дыры в метаданных и пишем качественные тексты
Title страницы — это то, что пользователь видит в сниппете поиска. Длина 50–60 символов для Google, до 70 для Яндекса. Включите главный ключ в начало, добавьте цифру или триггер: «5 способов проверить лицензию текста перед публикацией». Description до 150 символов должен раскрывать суть статьи и содержать призыв: «Узнайте, где искать контент в public domain и как адаптировать его под SEO без риска санкций».
В самом тексте убирайте водяные фразы. Каждое предложение должно нести факт, инструкцию или пример. Вместо «Метатеги важны для продвижения» напишите «Title с ключом в начале повышает CTR на 15–20% по данным Backlinko». Разбивайте полотно текста списками, таблицами, подзаголовками каждые 300–400 слов — это снижает отказы и увеличивает время на странице.
Умная перелинковка: как распределить ссылочный вес по страницам
Внутренние ссылки передают авторитет от одной страницы к другой и помогают поисковику понять структуру сайта. Размещайте 2–4 ссылки в тексте на смежные статьи или разделы каталога. Анкор должен точно описывать содержание целевой страницы: вместо «подробнее здесь» используйте «как составить техническое задание копирайтеру». Не ставьте ссылки на главную или контакты из каждой статьи — это размывает релевантность.
Эффективность перелинковки измеряется не количеством ссылок, а точностью передачи ссылочного веса на ключевые посадочные узлы сайта без размытия релевантности.
Следите за глубиной вложенности: важные страницы должны открываться за 2–3 клика от главной. Используйте блоки «Читайте также» в конце статьи, чтобы перевести пользователя на следующий этап воронки. Проверяйте битые ссылки через Google Search Console раз в месяц: каждая 404-ошибка — потерянный ссылочный вес и негативный сигнал для ранжирования.
Практический алгоритм: как стабильно качать органический трафик на сайт
Органический трафик растет не от количества опубликованных статей, а от точного попадания в запросы пользователей и технической оптимизации каждой страницы. Алгоритм состоит из трех этапов: сбор семантического ядра с группировкой запросов по интенту, создание контента с четкой структурой заголовков и внутренней перелинковкой, регулярный аудит позиций и обновление материалов под требования поисковиков. Копирование чужих текстов не работает — поисковики фильтруют дубли и понижают неуникальный контент. Пишите собственные статьи под кластеры запросов или переписывайте легальные источники.
Собираем семантику и кластеризуем запросы под реальных людей
Соберите список запросов через Wordstat, Ahrefs или SE Ranking — выгрузите все фразы по вашей теме с частотностью выше 10 показов в месяц. Отфильтруйте нерелевантные и сгруппируйте оставшиеся по интенту: информационные (как, что такое, почему), коммерческие (купить, цена, заказать), навигационные (название бренда, логин). Один кластер — одна посадочная страница.
Используйте инструменты кластеризации (KeyCollector, Rush Analytics, Topvisor) или группируйте вручную по пересечению топ-10 в выдаче. Если для двух запросов Google показывает одни и те же 7–8 сайтов — объединяйте их в один кластер. Для каждого кластера пропишите главный заголовок H1, список подзаголовков H2–H3 и целевые ключи — это основа будущей статьи.
Регулярный аудит и обновление страниц, чтобы удерживать топ в выдаче
Раз в квартал проверяйте позиции всех посадочных страниц в Яндекс.Вебмастере и Google Search Console. Статьи, которые упали с топ-3 в топ-10 или ниже, требуют обновления: добавьте 1–2 новых раздела с актуальной информацией, обновите цифры и примеры, перепроверьте внутренние ссылки на битые URL. Поисковики учитывают дату последнего изменения и свежесть контента.
Следите за конкурентами в выдаче: если их статьи обогнали вашу, откройте их в режиме чтения и зафиксируйте, какие блоки или данные они добавили. Дополните свой материал аналогичной или более полной информацией своими словами. Обновленную страницу отправьте на переиндексацию через форму в Search Console — эффект виден через 2–4 недели.