ChatGPT-4 помогает готовить SEO-контент, но его возможности ограничены размером запроса, числом обращений и правилами обработки данных. Если отправлять длинные задания без плана, часть условий потеряется, а генерация остановится на середине. Передавать модели внутренние документы рискованно: нужно понимать, как работает политика конфиденциальности ChatGPT и какие настройки доступны. В статье разберем 4 ограничения, которые влияют на SEO-производство, и покажем, как выстроить работу без попыток обойти лимиты: разбивать задачи на этапы, готовить семантику заранее и использовать локальные модели для чувствительных данных.
- ChatGPT-4 имеет жесткие лимиты: размер контекста (до 128 тыс. токенов), ограничение на вывод за один проход и квоты на частоту запросов — их нельзя обойти настройками или параллельными запросами, они проверяются на серверах OpenAI
- Русский текст расходует на 30–50% больше токенов, чем английский, поэтому статью на 8000 знаков нужно генерировать в несколько этапов по блокам (800–1200 слов за запрос)
- Данные в ChatGPT по умолчанию используются для обучения моделей (кроме API и Enterprise); персональные данные, пароли, договоры и коммерческую тайну туда загружать нельзя — для них применяют локальные LLM и обезличивание информации
- Эффективный воркфлоу строится на батчинге (разделение на 4–5 пакетов), подготовке семантики заранее и гибридном подходе: в ChatGPT отправляют обезличенные брифы, в локальную модель — чувствительные данные, результат собирают вне чата
Технические рамки модели: какие лимиты задают правила SEO-производства
Производство SEO-текстов на GPT-4 и GPT-4o регулируется инфраструктурой OpenAI: размером контекста, лимитом генерации за один проход и частотой обращений. Контекст задает, сколько данных модель удерживает одновременно — ТЗ, семантическое ядро, фрагменты статей из выдачи. Вывод ограничивает длину готового ответа, поэтому объемный лонгрид приходится собирать по частям. Частота определяет паузы между запросами и дневные квоты тарифа. Без учета этих трех рамок промпты обрезаются, требования теряются, а структура статьи распадается еще до редактуры.
Количественные ограничения на запросы и размер контекстного окна
Частота запросов зависит от тарифа и текущей нагрузки сервиса. Бесплатный доступ получает минимальную квоту и первым попадает под паузы в часы пик. Тарифы Plus, Team и Enterprise увеличивают число обращений за период и приоритет обработки, но не снимают ограничения полностью. При превышении квоты веб-интерфейс предлагает подождать, а API возвращает ошибку 429. Для SEO-потока это означает конкретное правило: очередь из 50 статей нельзя прогнать одним циклом без остановок.
Очередь из десятков статей невозможно прогнать через нейросеть за один клик без потери качества. Специалисты TzMonster отмечают, что для стабильного SEO-потока необходимо дробить задачи и учитывать паузы между запросами, иначе API просто заблокирует доступ из-за превышения квот.
Контекстное окно GPT-4 и GPT-4o исчисляется десятками и сотнями тысяч токенов, у GPT-4o — до 128 тыс. В этот объем входит все: системная инструкция, переписка, загруженные фрагменты и сам ответ. Фактически полезный остаток меньше заявленного: часть окна занимает история диалога и служебные токены. Если вставить в промпт ядро на 200 фраз, 10 URL конкурентов и требования к стилю, модель начнет забывать начало задания. Поэтому семантику чистят и делят на блоки перед отправкой.
Ограничения токеномики и влияние на генерацию объемного контента
Модель считает текст не символами, а токенами — фрагментами слов длиной 3–4 символа для английского и короче для русского. Русский текст расходует токенов на 30–50% больше при том же объеме, и это напрямую сокращает доступный контекст и вывод. Запрос на статью 12 000 знаков за один проход упирается в лимит ответа: генерация оборвется на середине раздела или сожмет выводы. Планирование объема ведут в токенах, а не в знаках: заголовок, введение и один раздел — один проход.
Объемный контент собирают по частям с фиксацией промежуточного результата. Рабочая схема: отдельный запрос на план, затем генерация по разделам с передачей только нужного среза семантики и фактов. Каждый следующий промпт содержит краткое резюме сделанного и требования к текущему блоку, а не всю переписку целиком. Такая нарезка сохраняет логику, держит плотность ключей и снижает расход контекста. Проверка сводится к стыковке блоков и удалению повторов на границах.
Почему технические лимиты API и веб-интерфейса нельзя преодолеть хитростью
Лимиты проверяются на серверах OpenAI по токенам, аккаунту и ключу API, а не в браузере. Открытие нескольких вкладок, переформулировка одного запроса подряд, смена User-Agent или параллельные скрипты квоту не увеличивают: запросы суммируются под одним аккаунтом и также приводят к паузе или ошибке 429. Агрессивная автоматизация обхода очередей нарушает условия использования и ведет к временной блокировке или отключению ключа. Технические рамки нельзя удалить настройкой или формулировкой — они заложены в инфраструктуру.
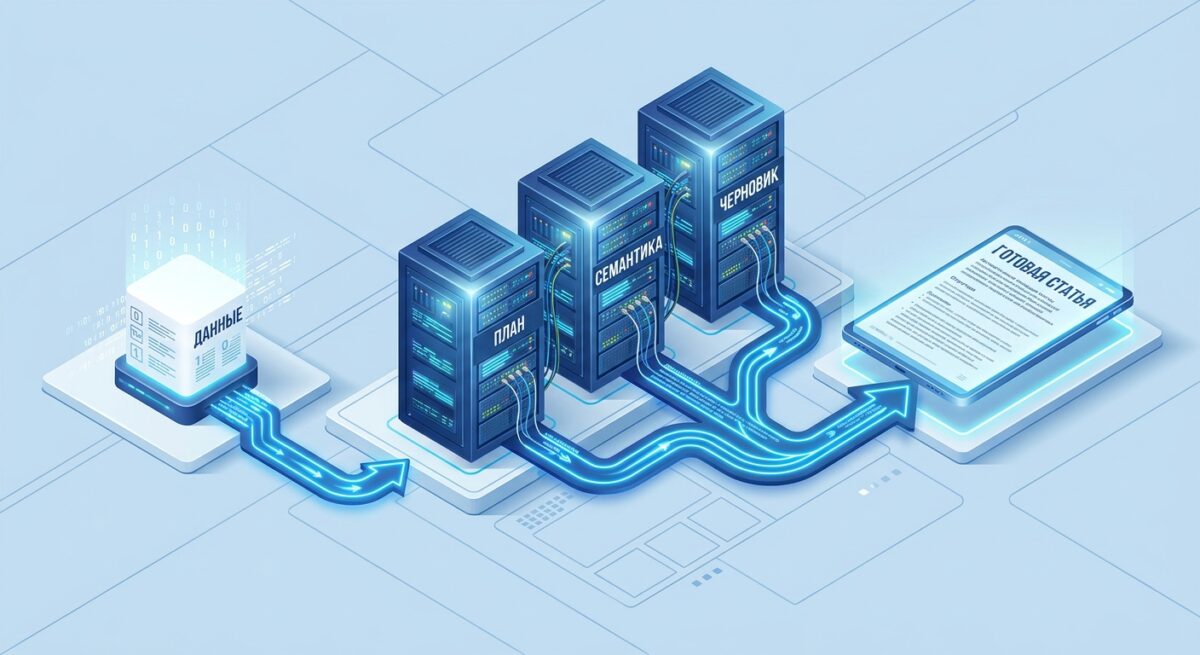
Корректное решение — распределять нагрузку, а не маскировать ее. SEO-задачи группируют в пакеты: сбор семантики, план, черновики разделов, проверка фактов — каждый пакет со своим бюджетом запросов. Для пиковых объемов подключают официальные каналы с большей квотой: Plus/Team для ручной работы и API с оплатой за токены для потока — и дополняют их локальными LLM для черновых операций без передачи чувствительных данных. Такой подход держит производство в рамках правил и дает предсказуемый темп выпуска.
🚀 Тексты, которые нравятся поисковикам
ТЗМонстр — умный нейропомощник для SEO и блогов. Автоматически собирает LSI-фразы, генерирует детальное ТЗ и пишет экспертные статьи лучше обычного ChatGPT. От 15₽ за готовый план работы.
Политика конфиденциальности ChatGPT: что происходит с данными в ваших чатах
Каждый запрос в ChatGPT проходит через серверы OpenAI: текст промпта, ответ модели, метаданные сессии и технические логи сохраняются для обеспечения работы сервиса, борьбы со злоупотреблениями и улучшения стабильности. Это означает, что удалить лимиты и получить полную анонимность в рамках одного бесплатного аккаунта не получится — обработка данных заложена в архитектуру. Для SEO-специалиста вывод практический: не загружайте в чат клиентские базы, договоры, доступы и неопубликованные тексты, планируйте задачи батчами и проверяйте настройки приватности тарифа перед стартом проекта.
Базовые положения политики конфиденциальности в отношении пользовательского контента
По условиям сервиса OpenAI хранит текст запросов, загруженные файлы и историю диалогов для поддержания работы аккаунта, предотвращения нарушений и разбора сбоев. Отдельно фиксируются IP-адрес, тип устройства, время сессии и технические логи, которые привязываются к учетной записи и хранятся установленный срок.
| Тарифный план | Обучение на данных (по умолчанию) | Срок хранения логов на сервере |
|---|---|---|
| Free / Plus | Да (можно отключить в настройках) | До 30 дней |
| Team / Enterprise | Нет | В соответствии с корпоративным договором |
| API | Нет | 30 дней (доступна опция Zero Data Retention) |
Удаление чата убирает его из интерфейса, но часть служебных копий сохраняется ограниченный период для безопасности. В тарифах Plus и Team доступны отключение истории и временные чаты, в Enterprise — отдельные договорные условия хранения. Проверяйте настройки перед загрузкой клиентского контента.
Как OpenAI использует переписки для обучения моделей по умолчанию
По умолчанию содержимое диалогов в бесплатной версии и Plus может использоваться для обучения и оценки моделей после удаления прямых идентификаторов. Опция улучшения модели отключается в настройках управления данными: после отключения новые переписки исключаются из обучающей выборки.
В Team и Enterprise данные клиентов по условиям тарифов не идут на обучение без отдельного согласия. Для API действует отдельная политика: запросы через API по умолчанию не используются для дообучения. Черновики статей планируйте в общем чате, аналитику с чувствительными метриками — через API или локальную LLM.
Риски утечки корпоративной информации и коммерческой тайны
Главный риск — человеческий фактор. Сотрудник копирует в промпт договор, финансовую таблицу, доступы к CMS или персональные данные клиентов. Такой текст попадает в логи, остается в общей истории команды и становится виден при совместном доступе к аккаунту.
- Финансовые документы: сметы, договоры и отчетности с реальными цифрами.
- Персональные данные: базы клиентов, номера телефонов и адреса почт.
- Техническая информация: логины, пароли и URL скрытых административных панелей CMS.
- Интеллектуальная собственность: неопубликованные стратегии, черновики статей и уникальный код.
Второй риск — компрометация. Неопубликованная стратегия из чата окажется доступна посторонним при взломе почты или утечке пароля. Решение: передавайте только обезличенную информацию, разбивайте ТЗ на батчи без названий брендов и держите исходники в собственном хранилище, а не в чате.
Настройки безопасности: как защитить конфиденциальность в рабочих проектах
ChatGPT обрабатывает запросы на серверах OpenAI: переписка сохраняется, проходит модерацию и хранится в логах. Полной конфиденциальности в обычном аккаунте не достичь. Для SEO-команды это означает разделение контуров: в модель отправляют обезличенные брифы, структуру и семантику, а персональные данные, доступы к CMS и договоры оставляют в локальном хранилище. Платные тарифы Plus, Team и Enterprise дают более высокие лимиты и управляемые настройки приватности, но не отменяют обработку на стороне провайдера. Ниже разберем три рабочих механизма: отключение истории и отказ от обучения, временные чаты и корпоративные договоры. Это снижает риски утечки без попыток обойти лимиты.
Способы отключения истории чатов и передачи данных для тренинга ИИ
Отключение истории находится в меню Settings — Data Controls — Chat History & Training: переключатель запрещает сохранять новые диалоги в панели и подает сигнал opt-out из обучения моделей. Настройка действует только для будущих чатов. Старые переписки удаляются вручную, запросов на удаление данных это не заменяет.
Дополнительно используют Privacy Request Portal OpenAI и настройки API-кабинета, где отключают передачу контента для улучшения сервиса, если команда работает через API. Для SEO действует правило: перед генерацией из промпта убирают имена, телефоны, URL закрытых админок и оставляют только ключи, структуру и обезличенные примеры.
Использование временных чатов для конфиденциальных задач
Временный чат запускается через переключатель Temporary Chat в меню модели: такой диалог не сохраняется в истории и не используется для обучения, но кратковременно хранится на сервере для модерации и безопасности. После закрытия его нельзя восстановить, поэтому удачные промпты, структуру и выводы сразу копируют в рабочие документы.
В SEO временные чаты подходят для разбора чувствительных черновиков: семантика конкурента, письмо клиента, тест офферов без сохранения в аккаунте. Для массовых задач они лимиты не снимают: ограничения GPT-4/4o по токенам и частоте действуют так же, поэтому кластеризацию и генерацию разбивают на батчи и ведут в обычных проектах с обезличенными данными.
Правовые границы использования корпоративных аккаунтов Team и Enterprise
Тарифы Team и Enterprise добавляют договорные обязательства: данные рабочего пространства по умолчанию не используются для обучения моделей, доступны SSO, управление ролями, журналы и политики удержания. Администратор распределяет места, ограничивает общие GPT и интеграции, что снижает риск случайной отправки чувствительных файлов всей командой.
Граница сохраняется: обработка и хранение запросов на инфраструктуре провайдера нужны для работы сервиса, модерации и защиты от злоупотреблений. Абсолютную приватность гарантировать нельзя. Персональные данные, NDA и финансы в ChatGPT не загружают, для них используют локальные LLM и собственное хранилище, а в корпоративном аккаунте держат только обезличенные SEO-задачи.
Абсолютной приватности в облачных ИИ-сервисах не существует. Даже на корпоративных тарифах ваши запросы проходят через серверы провайдера, поэтому самым надежным файрволом остается жесткое обезличивание данных до их попадания в промпт.
Эффективный воркфлоу: как обходить ограничения архитектурно, а не технически
Лимиты ChatGPT-4 заданы инфраструктурой OpenAI: размер контекста, число запросов в час и правила хранения данных нельзя отключить настройкой или дополнительным аккаунтом. Решение — спроектировать работу так, чтобы каждый запрос был коротким, завершенным и не требовал от модели помнить лишнее. Черновики, факты и семантика хранятся у вас, в модель уходит только конкретная операция: план, черновик раздела, сжатие, проверка логики. Тарифы Plus, Team и Enterprise повышают пороги и дают формальные условия обработки данных, API и локальные модели закрывают пиковые задачи. Ниже — четыре узла такой схемы.
Построение контент-пайплайна через батчинг задач и пакетную обработку
Батчинг превращает 30 разрозненных запросов в 4–5 пакетов: бриф, структура, черновики разделов, редактура. Вместо задания «напиши статью на 8000 знаков» отправляйте задачу на один блок объемом 800–1200 слов с указанием тезисов, ключей и запрета на выдумки. Короткий контекст помещается в лимит токенов GPT-4/4o, ответ не обрывается, а повторный запрос не тратит лимит на пересказ условий.
Готовые блоки складывайте в документ и собирайте статью вне чата. Следующий пакет ссылается только на итог предыдущего: заголовки и 3–4 факта, а не всю переписку. Так укладываетесь в частоту запросов и получаете предсказуемый результат без потери деталей.
Гибридный подход: комбинация с локальными моделями для чувствительных данных
В ChatGPT нельзя передавать пароли, персональные данные клиентов, внутреннюю аналитику и тексты под NDA: запросы проходят обработку на серверах OpenAI и хранятся согласно тарифу и настройкам. Для таких фрагментов используйте локальную LLM на своем компьютере или корпоративном сервере: она работает офлайн, не отправляет текст наружу и подходит для черновой обработки закрытых абзацев.
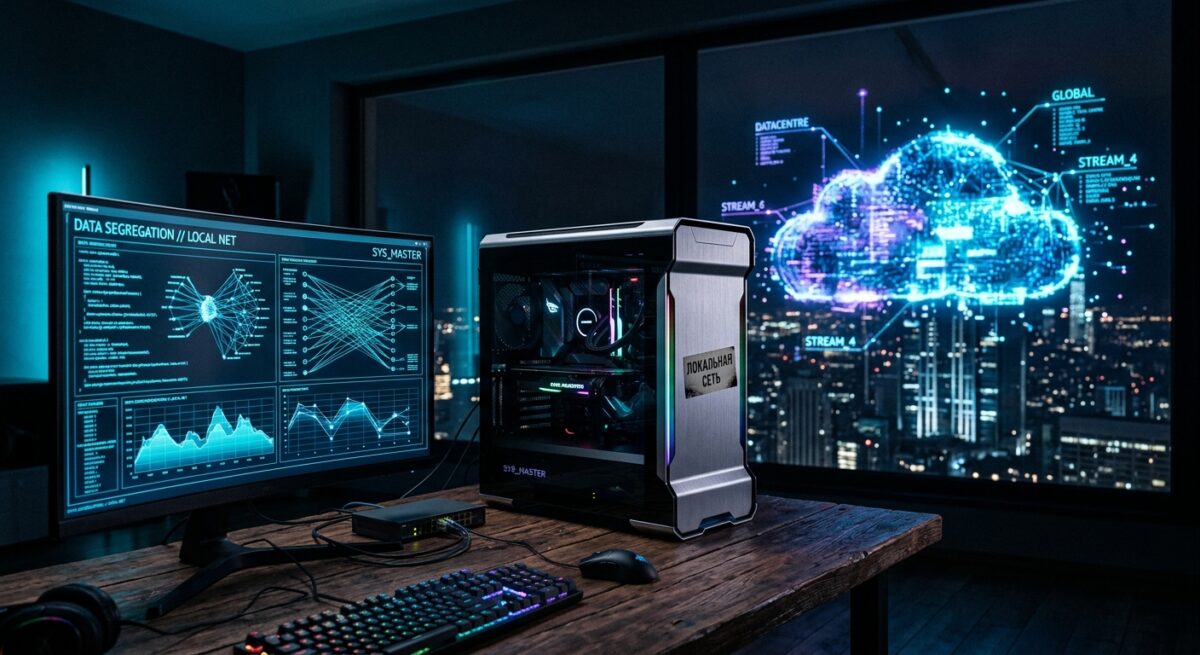
Гибридная схема работает так: обезличенный план и структура — в ChatGPT, персональные и коммерческие детали — только локально. Перед отправкой в облако заменяйте имена, цифры выручки и адреса на плейсхолдеры вида [Клиент] и [Сумма]. Финальную сборку делайте у себя, поэтому закрытые данные не покидают ваш контур.
Роль качественного семантического ядра в снижении нагрузки на нейросеть
Подготовленное семантическое ядро сокращает число обращений к модели в 2–3 раза: не приходится перегенерировать текст из-за пропущенных запросов. Соберите кластер до промпта — 8–15 основных фраз, 20–30 LSI-синонимов, вопросы из подсказок поиска. На их основе зафиксируйте заголовки H2–H3 и тезисы под каждый блок.
Промпт тогда содержит готовый каркас: раздел 2, ключи лимит токенов GPT-4 и частота запросов, объем 600 знаков, вывод — список. Модели остается только формулировка, а не подбор фактов. Проверка проста: если черновик закрывает все пункты ядра, дополнительные итерации не нужны, а лимит запросов экономится.
Сценарии интеграции ИИ в рабочий процесс без риска для индексации и безопасности
Безопасный сценарий: ИИ готовит структуру, черновик и варианты мета-описаний, человек проверяет факты, добавляет опыт и переписывает шаблонные фрагменты. Сырой сгенерированный текст публиковать нельзя: он содержит повторы, общие фразы и ошибки в цифрах, что ухудшает поведенческие метрики и доверие поиска.
Сырой сгенерированный текст — это бомба замедленного действия. Без фактчекинга и ручной редактуры шаблонные фразы и выдуманные цифры неизбежно приведут к падению поведенческих метрик и потере доверия поисковых систем.
Разделите роли явно: официальный аккаунт или API — для открытых тем, локальная модель — для внутренних данных, CMS — для хранения итогов. Ведите журнал запросов и версий, не вставляйте в промпты доступы и ключи. Такая цепочка дает стабильный выпуск 5–10 статей в неделю без пиковых перегрузок и без передачи критичных сведений наружу.