ChatGPT-5 и 5.5 уже доступны и работают в десятках редакций. Но ни одна версия не заменит семантику, структуру и проверку фактов. Это инструмент для черновиков и ресерча, а не волшебная кнопка для трафика. В этой статье разберем, что реально изменилось в генерации текстов, как встроить модель в рабочий конвейер — от кластеров до метатегов и FAQ — и какие ошибки роняют позиции.
- GPT-5 ускоряет ресерч и генерацию черновиков на 40–60%, но не заменяет работу SEO-специалиста над семантикой, структурой и проверкой фактов — модель склонна к галлюцинациям в цифрах и датах
- Эффективный конвейер: семантика → кластеризация → структура ТЗ → черновик от ИИ → редактура с фактчекингом и экспертными вставками; пропуск любого этапа приводит к потере позиций
- Модель незаменима в рутине: массовая генерация метатегов, FAQ, микроразметки, переписывание устаревшего контента; окупаемость подписки зависит от четкого разделения ролей между ИИ и редактором
Развенчиваем мифы об идеальном ИИ и смотрим на реальные задачи GPT-5 в SEO
ChatGPT-5 уже доступен. Вместе с ним жива иллюзия, что модель возьмет тему, сама соберет семантику и выдаст статью в топ без участия человека. Так это не работает. GPT-5 ускоряет ресерч, собирает черновик и варианты заголовков, но решения о структуре, кластерах и фактуре остаются за оптимизатором. Ниже — три разбора: почему ожидание «чудо-кнопки» тормозит трафик, что реально поменялось в генерации текстов и где проходит граница между работой нейросети и задачами редактора.
Почему вера в волшебную кнопку только тормозит рост трафика
Пока вы ждете версию, которая «сделает все сама», конкуренты публикуют статьи, собранные по процессу: ядро → структура → черновик от ИИ → редактура. Ожидание релиза — это упущенные месяцы индексации. Google и Яндекс ранжируют не по номеру модели, а по пользе, структуре и поведенческим факторам, которые модель без вашего участия не выстроит.
Ожидание идеальной нейросети, которая сама выведет сайт в топ, обходится бизнесу слишком дорого. Пока вы ждете чуда, ваши конкуренты уже публикуют гибридный контент и забирают поисковый трафик.
Вторая ловушка — сырой вывод модели публикуют как есть. Текст без семантики, без логики заголовков и с непроверенными фактами проседает в выдаче и роняет поведенческие метрики. Чем сильнее вера в автоматизм, тем ниже внимание к доработке — и тем хуже результат. Инструмент экономит время, но не отменяет работу над смыслом.
Что на самом деле изменилось в генерации текстов с приходом GPT-5
GPT-5 и 5.5 лучше держат контекст длинного брифа, точнее следуют структуре из ТЗ и выдают меньше «воды» на запрос. Модель быстрее кластеризует список ключей, предлагает варианты H2–H3 и собирает черновик по заданному плану. Это ускоряет этап черновика в разы — там, где раньше уходил день, теперь час на генерацию и правку.
Но ограничения остались. Модель уверенно выдает неточные цифры, устаревшие данные и несуществующие источники — это называют галлюцинациями. Она не знает актуальной выдачи по вашему запросу и реальных интентов аудитории. Поэтому фактуру, свежесть и экспертность добавляет человек. Версия стала сильнее как ассистент, но не стала автономным SEO-специалистом.
Где заканчивается зона ответственности нейросети и начинается работа оптимизатора
Нейросеть отвечает за скорость: собрать черновик, переписать абзац, предложить синонимы LSI, сгенерировать варианты FAQ и сниппетов. Это рутина, которую модель закрывает быстрее человека. На этом ее зона заканчивается — дальше начинается то, что определяет позиции.
Оптимизатор отвечает за семантическое ядро, группировку запросов по интентам, логику структуры и перелинковку. Он проверяет каждый факт, добавляет экспертные детали и примеры, которых нет в обучающих данных модели. Именно эта часть создает пользу и отличает статью из топа от сгенерированного шаблона. GPT-5 — помощник на конвейере, а не замена того, кто этот конвейер настраивает.
🚀 Тексты, которые нравятся поисковикам
ТЗМонстр — умный нейропомощник для SEO и блогов. Автоматически собирает LSI-фразы, генерирует детальное ТЗ и пишет экспертные статьи лучше обычного ChatGPT. От 15₽ за готовый план работы.
Пошаговый конвейер: от сырой семантики до готового материала
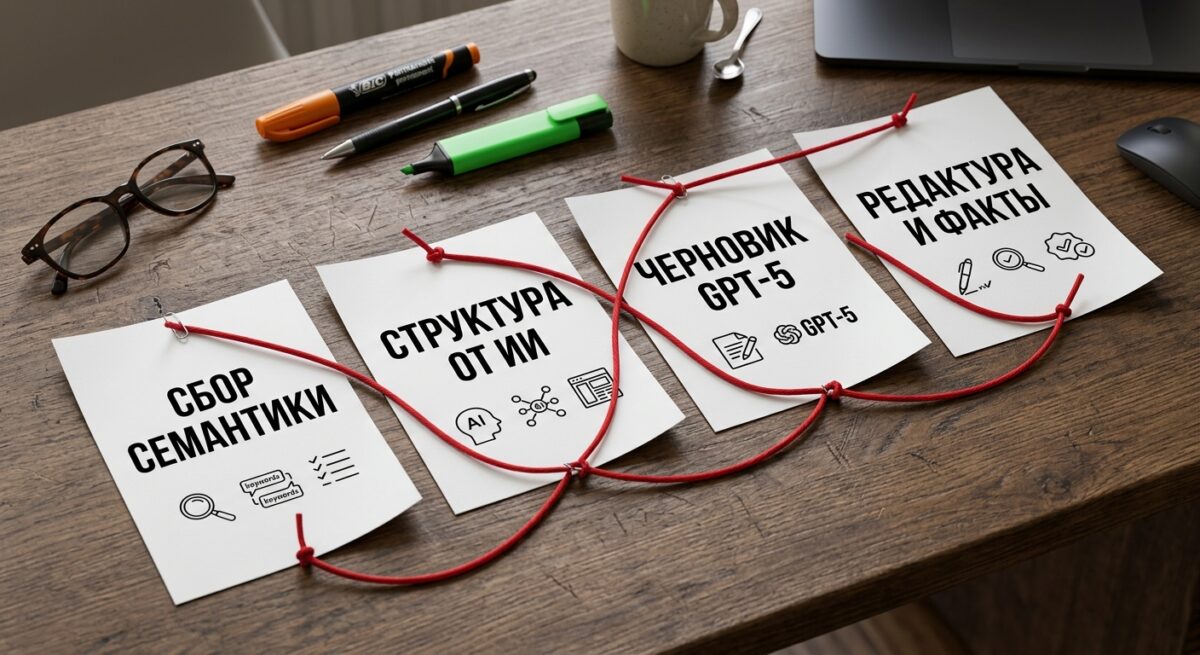
Рабочий процесс делится на четыре этапа: сбор семантики, структура, черновик от ИИ, редактура. Модель GPT-5 подключается не на старте и не вместо SEO-специалиста, а внутри этой цепочки. Сначала классические инструменты — Key Collector, Serpstat, Wordstat — дают пул запросов и частотности. Потом ИИ помогает их сгруппировать и превратить в скелет статьи. Затем генерирует черновик по вашему ТЗ. И только потом редактор добавляет факты, цифры и экспертизу. Пропустите любой шаг — и получите текст без структуры и без позиций. Ниже разберем каждый этап по порядку.
Шаг первый: собираем кластеры и выстраиваем структуру с помощью ИИ
Выгрузите семантическое ядро из привычного инструмента и передайте список запросов в GPT-5 с задачей сгруппировать их по смыслу и интенту. Модель разложит сотни фраз на кластеры: информационные отдельно, коммерческие отдельно, смежные подтемы отдельно. Проверяйте результат вручную по выдаче — ИИ иногда склеивает запросы с разным интентом, и это ломает логику будущей страницы.
После кластеризации попросите модель построить структуру статьи: заголовки H2 и H3 под каждую группу запросов. На выходе получите каркас, где каждый блок закрывает конкретную потребность пользователя. Такой скелет сразу показывает, какие подтемы вы упустили и где у конкурентов из топа есть разделы, которых у вас нет. Это основа под следующий шаг — техническое задание.
- Фильтрация мусора: ИИ часто ошибочно захватывает информационные запросы в коммерческие кластеры.
- Проверка интента: Обязательно сверяйте логику кластеров нейросети с реальной выдачей поисковиков.
- Скрытые пробелы: Используйте сгенерированный каркас H2-H3, чтобы найти упущенные подтемы, которые уже раскрыты у топ-10 конкурентов.
Шаг второй: пишем детальные технические задания для копирайтеров
На готовую структуру наращивается ТЗ. Дайте GPT-5 кластеры и каркас, попросите собрать для каждого раздела список LSI-слов, вопросы для блока FAQ и тезисы, которые нужно раскрыть. Укажите в промпте тип текста, целевую аудиторию и объем. Модель вернет бриф с ключами, которые стоит вписать, и смысловыми акцентами по каждому подзаголовку.
Доработайте ТЗ сами: добавьте требования к источникам, запретите воду и штампы, пропишите, какие цифры и примеры обязательны. ИИ не знает специфику вашей ниши и актуальные данные, поэтому жесткие рамки задаете вы. Чем конкретнее ТЗ, тем меньше правок на выходе — копирайтер и сама модель на следующем шаге работают по четкому заданию, а не по догадкам.
Шаг третий: генерируем черновики и насыщаем их экспертной фактурой
Прогоните готовое ТЗ через GPT-5 по разделам, а не всю статью одним запросом. Поблочная генерация держит модель в рамках структуры и не дает ей уплывать в общие фразы. На выходе получите связный черновик, который закрывает каркас и уже содержит заложенные ключи. Это заготовка, а не финальный текст — воспринимайте результат как сырье для редактуры.
Главная работа начинается после черновика. Проверяйте каждый факт, цифру и утверждение: модель уверенно выдает несуществующие данные и устаревшую статистику. Добавьте то, чего ИИ не знает, — свежие кейсы, личный опыт, результаты тестов, скриншоты. Именно эта экспертная фактура отличает текст в топе от тысяч одинаковых генераций и показывает поисковику реальную пользу.
Технические фишки GPT-5, которые реально облегчат жизнь оптимизатору
GPT-5 и 5.5 изменили не качество текста как таковое, а скорость подготовки материала и глубину ресерча. Модель держит в контексте десятки страниц конкурентов, реже путается в цифрах и точнее выполняет сложные многошаговые промпты. Для оптимизатора это значит одно: рутина вроде анализа выдачи, сборки структуры и черновиков съедает меньше часов. Разберем три возможности, которые чаще всего экономят время редакции, и покажем, как применять их без потери качества и без штрафов за непроверенную фактуру.
Огромные контекстные окна для глубокого анализа конкурентов
Контекстное окно GPT-5 вмещает сотни тысяч токенов — это тексты 10–15 статей из топа одновременно. Раньше приходилось скармливать материалы по одному и терять связи между ними. Теперь можно загрузить всю выдачу по запросу и попросить модель выделить общие подтемы, уникальные блоки у каждого конкурента и пробелы, которые никто не закрыл.
На практике это ускоряет сбор структуры. Вы получаете список подзаголовков, которые встречаются у всех, и идеи, которых нет ни у кого — потенциал выйти вперед по полноте. Проверять выводы все равно нужно вручную: модель видит текст, но не видит реальные позиции и поведенческие метрики. Сопоставляйте ее подсказки с данными из Keys.so или Ahrefs.
Анализ конкурентов через ИИ дает мощный старт, но требует ручной верификации. Специалисты TzMonster отмечают, что нейросеть видит только текст, но не учитывает поведенческие метрики и реальный вес страниц в выдаче, поэтому слепое копирование структуры конкурентов может навредить.
Точное попадание в промпты и минимум галлюцинаций в цифрах
GPT-5 стабильнее следует инструкциям: если в промпте заданы объем, количество подзаголовков и формат вывода, модель держит эти рамки без постоянных напоминаний. Это убирает часть ручной правки структуры и экономит итерации.
С цифрами ситуация улучшилась, но не стала идеальной. Модель реже выдумывает статистику и даты, однако выдумывает до сих пор. Любую цифру — долю рынка, год, процент конверсии — проверяйте по первоисточнику. Рабочее правило: просите GPT отмечать факты, в которых он не уверен, и не публикуйте ни одной цифры без сверки. Фактчекинг остается за редактором, а не за моделью.
Кастомные инструкции под Tone of Voice бренда
Через кастомные инструкции и проекты в ChatGPT можно один раз задать правила бренда: запрещенные слова, длину предложений, обращение на «вы», примеры удачных и неудачных формулировок. Модель запоминает их для всех чатов и перестает скатываться в канцелярит или рекламные штампы, которые потом приходится вычищать.
Это логично продолжает точность из прошлого блока: четкие рамки на уровне стиля так же снижают число правок, как четкие рамки на уровне структуры. Загрузите в инструкции 2–3 эталонных текста редакции и список стоп-слов. Черновики сразу выходят ближе к вашему голосу, но финальную шлифовку и смысловую плотность по-прежнему дает человек.
| Задача оптимизации | Зона ответственности GPT-5 | Зона ответственности человека |
|---|---|---|
| Сбор фактуры и данных | Быстрый поиск базовых определений и LSI | Проверка цифр, дат и добавление реальных кейсов |
| Создание структуры | Генерация вариантов H2-H3 по готовому кластеру | Утверждение логики и соответствия интенту |
| Написание текста | Генерация связного черновика без «воды» | Добавление Tone of Voice и экспертного мнения |
Где нейросеть незаменима в ежедневной рутине
Нейросеть экономит часы на однотипных задачах, где важна скорость, а не авторская экспертиза. Это генерация сотен метатегов, сбор FAQ по кластеру, перефразирование устаревших абзацев, подготовка шаблонов анонсов и кратких описаний товаров. В этих операциях нет тонкой смысловой работы — есть объем и повторяющаяся структура, которую модель держит стабильно. Редактор в таком сценарии не пишет с нуля, а задает рамку и проверяет результат. Ниже три сценария, где GPT-5 реально снимает рутину с команды и ускоряет выпуск контента в разы без потери качества.
Массовая генерация метатегов Title и Description на автопилоте
Прописать Title и Description вручную для каталога из 500 карточек — это несколько дней монотонной работы. GPT-5 закрывает задачу за один прогон: вы отдаете модели таблицу с названиями товаров, ключами и шаблоном, а на выходе получаете метатеги под каждый URL. В промпт закладываете ограничения по длине — до 60 символов для Title и до 155 для Description — и требование вписать главный ключ в начало.
Важно не публиковать результат вслепую. Модель иногда дублирует формулировки и теряет уникальность по кластеру похожих страниц. Поэтому финальный шаг — выгрузка в таблицу и проверка на повторы и переспам. Задайте в промпте разные конструкции призыва к действию для соседних карточек, чтобы сниппеты не выглядели клонами в выдаче. Так вы сохраняете скорость генерации и контроль над качеством каждого метатега.
Собираем расширенные FAQ и микроразметку по следам поисковой выдачи
Блок FAQ забирает длинные хвостовые запросы и повышает шанс попасть в расширенный сниппет. Чтобы вопросы были реальными, а не выдуманными, сначала соберите подсказки из блока «Люди также спрашивают» и поисковых предложений по теме. Затем передайте этот список в GPT-5 с задачей сформулировать короткие точные ответы на 2–3 предложения. Модель структурирует разрозненные запросы в логичный блок и убирает дубли по смыслу.
Следующий шаг — разметка. Попросите модель обернуть готовый FAQ в структуру schema.org FAQPage в формате JSON-LD. Вы получите готовый код для вставки в head страницы без ручной верстки тегов. Проверьте результат в валидаторе разметки Google: модель изредка путает синтаксис или оставляет лишние запятые. После проверки блок работает на видимость в выдаче и отвечает на вопросы пользователя прямо в сниппете.
Как освежить старый контент и не уронить позиции в поиске
Старые статьи теряют трафик, когда устаревают факты, цифры и примеры. Полное переписывание опасно: вы рискуете сбросить накопленные поведенческие сигналы и позиции. Безопаснее точечное обновление. Отдайте GPT-5 текущий текст и свежие данные, попросите заменить устаревшие абзацы, добавить новые подзаголовки под появившиеся запросы и усилить разделы с проседающими метриками. Структуру и URL при этом трогать не нужно.
Не доверяйте модели фактуру вслепую — GPT-5 может подставить правдоподобную, но ложную цифру или дату. Все новые данные сверяйте с первоисточниками перед публикацией. Используйте модель для формы: переформулировать тяжелые предложения, добавить список, расширить тонкий раздел. После правок обновите дату публикации и переотправьте страницу на переобход через вебмастер. Так обновление поднимает актуальность без риска для текущих позиций.
Главные грабли при внедрении ИИ в оптимизацию сайтов
Модель выдает гладкий текст — и редактор расслабляется. Это основная ошибка: ИИ генерирует правдоподобную форму, но не отвечает за содержание. Три провала повторяются чаще всего. Первый — публикация без фактчекинга, когда в статью попадают выдуманные цифры и несуществующие источники. Второй — ставка на автоматизацию в ущерб интенту: текст есть, а на запрос пользователя он не отвечает. Третий — потеря голоса бренда, когда все материалы звучат одинаково усредненно. Разберем каждую проблему и способ ее обойти в реальном процессе.
Гладкий и стилистически правильный текст от нейросети часто усыпляет бдительность редактора. Это главная ловушка: ИИ отвечает исключительно за форму подачи, но совершенно не гарантирует достоверность содержания.
Почему нельзя публиковать сырые тексты без проверки фактов
GPT-5 и 5.5 склонны к галлюцинациям: модель подставляет убедительные, но ложные данные — даты, проценты, названия исследований, цитаты экспертов. Для информационной статьи это прямой удар по E-E-A-T. Google понижает страницы с недостоверной фактурой, а читатель, поймавший вас на ошибке, уходит и не возвращается. Одна выдуманная цифра в YMYL-тематике способна обнулить доверие ко всему разделу сайта.
Рабочее правило: каждое число, имя и утверждение из черновика ИИ проверяйте по первоисточнику перед публикацией. Статистику — по отчетам и официальным данным, цитаты — по оригиналу, законы и нормы — по актуальной редакции документа. ИИ дает скелет и формулировки, а ответственность за факты несет редактор. Этот этап нельзя делегировать модели — она не знает, где правда.
Как слепая вера в автоматизацию убивает поисковый интент
Поставить задачу «напиши статью про Х» и опубликовать результат — значит промахнуться мимо запроса. Модель не видит выдачу и не понимает, что реально ищет пользователь: инструкцию, сравнение, цену или определение. В итоге текст отвечает на абстрактную тему, а не на конкретный интент, под который собрано ядро. Позиции не растут, потому что страница не закрывает задачу человека.
Интент определяют до генерации — через анализ топа по запросу и структуры конкурентов. Сначала вы фиксируете, какой формат ответа ждет Google и пользователь, затем превращаете это в структуру и ТЗ, и только после прогоняете промпт. ИИ наполняет готовый каркас, а не придумывает смысл с нуля. Автоматизируйте черновик и рутину, но решение о том, что должно быть на странице, оставляйте за собой.
Как не потерять уникальность бренда из-за шаблонных формулировок
Без настройки модель пишет усредненным языком: одинаковые вступления, обтекаемые фразы, нейтральный тон. Десять статей от одного ИИ-конвейера звучат как клоны конкурентов, и читатель не отличает ваш бренд от соседнего. Для поисковика это сигнал низкой ценности — такой контент не добавляет к выдаче ничего нового и теряет в поведенческих факторах.
Голос бренда задают через контекст в промпте: примеры ваших текстов, редполитику, запрет на штампы, тон и терминологию ниши. Добавляйте то, чего у модели нет, — кейсы из практики, внутренние данные, мнение штатного эксперта, конкретные примеры из вашего опыта. ИИ собирает основу, а узнаваемость и экспертность вносите вы. Именно это отличает статью, которая держится в топе, от текста, который сливается с фоном.
Считаем деньги: как оценить пользу от GPT-5 в команде
Польза от GPT-5 измеряется не впечатлениями, а двумя цифрами: сколько часов экономят редакторы и SEO-специалисты и как меняется поисковый трафик. Если модель сокращает время на черновик с 4 часов до 1,5, но текст приходится переписывать, экономии нет — есть иллюзия. Считать нужно сквозной показатель: стоимость статьи от брифа до публикации плюс позиции через 2–3 месяца. Подписка на GPT-5 стоит фиксировано, а отдача зависит от процесса. Разберем три метрики, по которым видно, окупается ли инструмент или просто создает видимость работы.
Окупаемость рабочего времени редакторов и SEO-специалистов
GPT-5 забирает рутину: сбор черновых тезисов, расшифровку интервью, первичную структуру по кластеру запросов, генерацию вариантов заголовков и FAQ. На этих задачах редактор экономит 40–60% времени. Пример: статья на 8000 знаков раньше занимала рабочий день, с черновиком от модели — полдня. Освободившиеся часы уходят на фактчекинг, экспертные вставки и работу со смыслом — то, что модель не делает.
Опасность в обратном эффекте. Если редактор принимает черновик как финал, он тратит время на вычитку мусора и исправление выдумок модели. Тогда экономии нет: правки съедают сэкономленные часы. Окупаемость появляется только там, где зоны ответственности разделены — модель готовит заготовку, человек отвечает за достоверность и экспертизу. Эта логика напрямую определяет, как считать затраты на подписки.
Реальная экономия возникает только при строгом разделении ролей. Если редактор тратит сэкономленные на черновике часы на исправление галлюцинаций нейросети, внедрение ИИ превращается в фикцию, которая не окупает подписку.
Затраты на подписки и API против роста поискового трафика
Подписка на GPT-5 обходится в фиксированную сумму на пользователя, доступ через API тарифицируется по токенам. Для редакции из пяти человек с потоком 30–40 статей в месяц расходы предсказуемы и невелики на фоне фонда оплаты труда. Главный вопрос не в цене подписки, а в том, растет ли органический трафик на материалах, где использовалась модель.
Корректная оценка выглядит так: берете когорту статей с ИИ-черновиком и когорту без, сравниваете динамику позиций и переходов через квартал. Если тексты с ИИ не проседают по поведенческим факторам и выходят быстрее — подписка окупается скоростью. Если позиции хуже из-за слабой структуры и непроверенных фактов, проблема не в тарифе, а в процессе. Отсюда вывод: платить за доступ стоит только при выстроенном гибридном конвейере.
Строим гибридные процессы для штатных сотрудников и подрядчиков
Гибридный процесс закрепляет роли. SEO-специалист собирает семантику и кластеры классическими инструментами и формирует ТЗ. Модель получает ТЗ и выдает структуру, черновик, варианты метатегов и FAQ. Редактор доводит текст: проверяет факты, добавляет экспертные детали, вычищает штампы. Такое разделение не дает свалить все на ИИ и сохраняет управляемость качества.
С подрядчиками схема жестче: в договоре прописывают, что ИИ допустим как инструмент черновика, но ответственность за фактуру и уникальность смысла несет исполнитель. Проверка — через выборочный фактчекинг и анализ структуры под семантическое ядро. Так штатные сотрудники и фрилансеры работают по единым правилам, а деньги на подписки и часы превращаются в предсказуемый рост трафика, а не в разовый всплеск текстов без результата.